

 Помощь
 Документация

 Вход


OpenWebUI умеет использовать многое: кастомные модели, базу знаний (RAG), инструменты (MCP/tools), навыки и т. д. С каждой версией возможностей у среды всё больше, и кажется, что для ИИ-бота техподдержки достаточно создать кастомную модель на базе чего-то открытого типа Qwen-3.8 или Gemma 4, навесить на неё в настройках нужные инструменты, заполнить и подключить базу знаний — и готово!
Скажу честно: мы в HOSTKEY так и начинали. А потом написали несколько пайпов на каждый канал поддержки, который обслуживается своим ботом, потому что на настройках это работало, мягко говоря, непредсказуемо.
В этой статье мы расскажем не «как включить инструменты» — это всё есть в документации OpenWebUI, а «почему включить их недостаточно» и как устроены сейчас пайпы для ботов на примере техподдержки Remote Hands Request.
Закажите сервер с персональным AI-чат-ботом на вашем собственном сервере.
Что происходит, если положиться на настройки модели
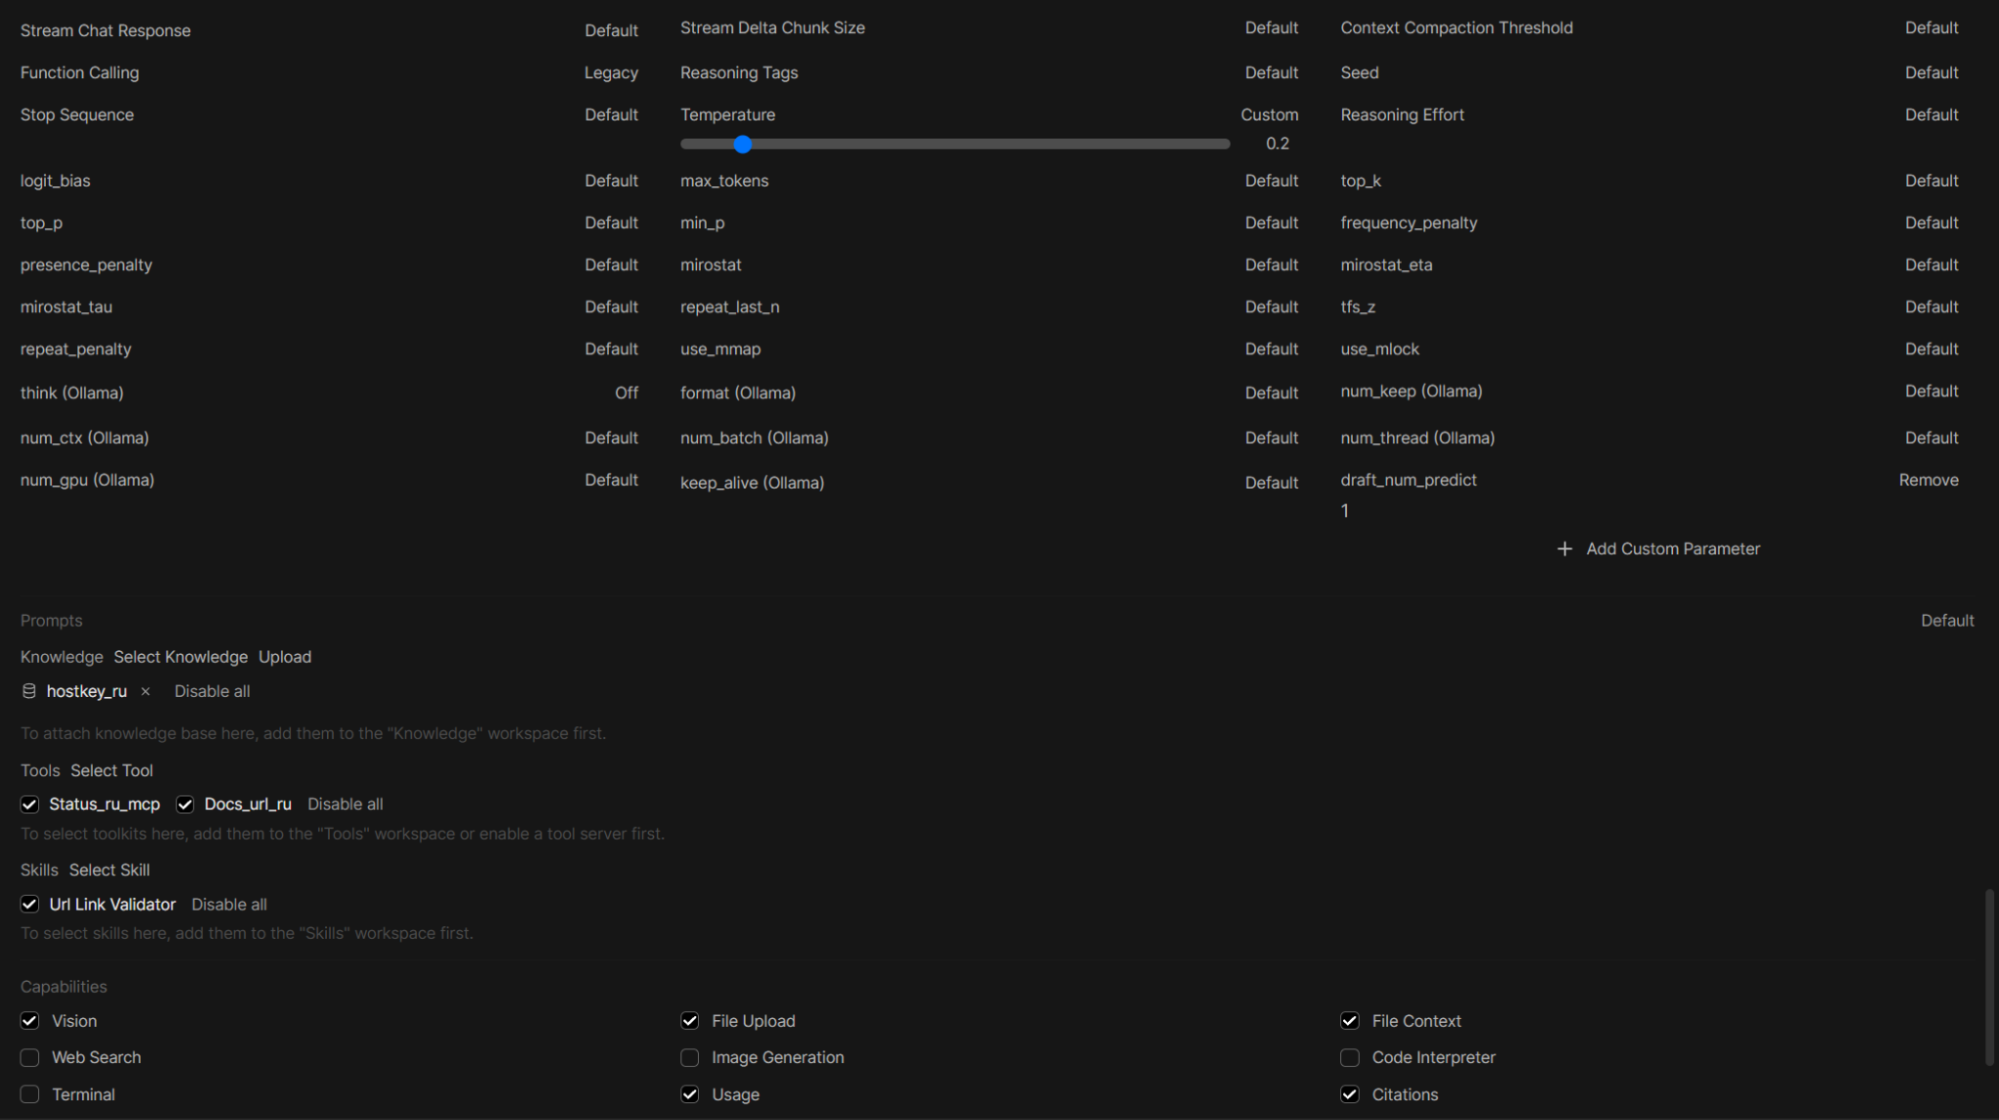
Для примера возьмём кастомную модель hostkeyrurhr, основанную на gemma4:26b-a4b-it-qat. В её настройках (как их видно на скриншоте из OpenWebUI) включены следующие параметры:
- Function Calling — Legacy;
- Temperature — 0.2, think (Ollama) — Off, draft_num_predict — 1;
- Knowledge — коллекция hostkey_ru, основанная на нашей клиентской документации;
- Tools — status_ru_mcp, docs_url_ru (проверка состояния работы сайта, инвапи и дата-центров в России и MCP инструмент запроса конфигураций VPS и выделенных серверов и сетевого трафика).
Зададим вопрос, под который у модели есть подходящий инструмент. Инструмент get_vps_list из внешнего MCP возвращает список VPS с ценами по локации, поэтому спросим про дешёвый VPS в Германии.
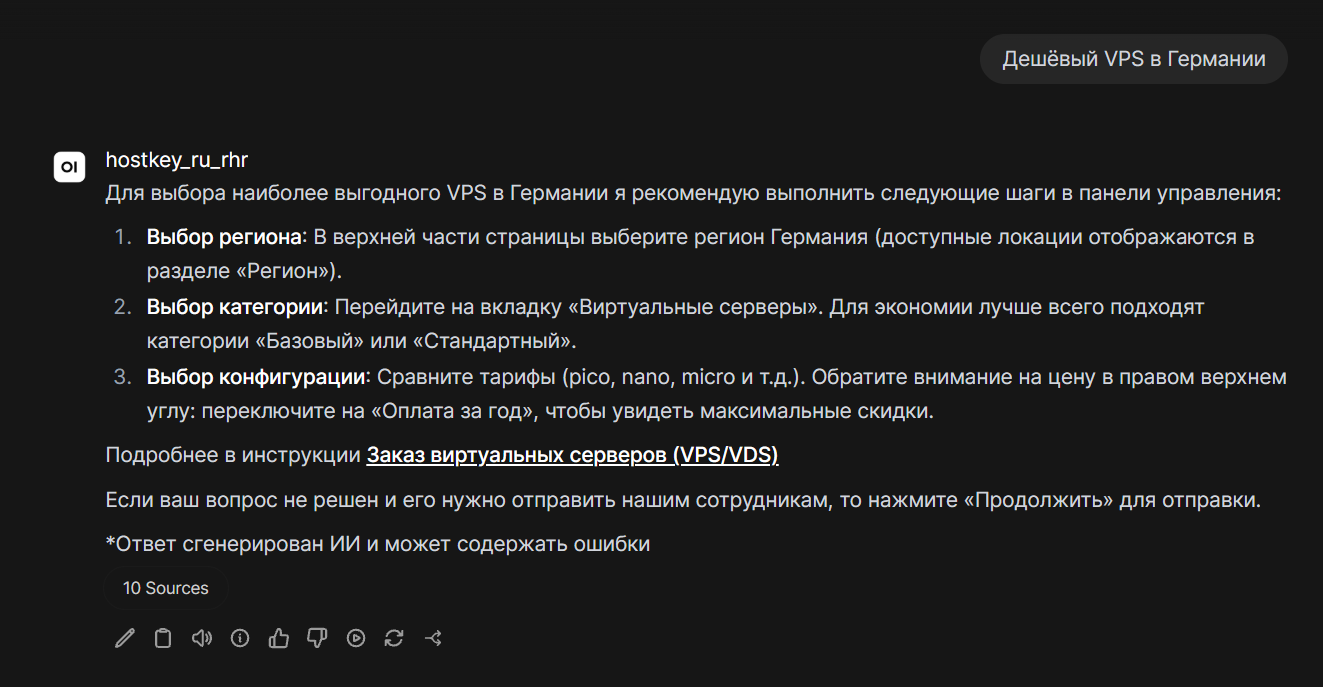
Актуальный список серверов и цены можно запросить через API в Invapi, и это как раз делает наш MCP-сервер, но модель за ними не идёт. Ответ строится только на RAG: он выглядит правдоподобно, однако это не данные из системы, а пересказ инструкции из документации. Если переключить в Native режим, то становится ещё хуже и «отваливается» уже и RAG.
При запросе через API (например, через CURL) ситуация ещё веселее: мы получаем голый tool_call с пустым content. Вызывать его и переспрашивать модель обязан клиент (что по факту и делает OpenWebUI). При этом никакой гарантии, что инструмент вызовется, что данные попадут в ответ, что они не смешаются с RAG и что ответ точно будет на русском, нет.
Но прежде чем разбираться с пайпами, стоит объяснить, почему в настройках модели стоит Legacy и почему нельзя просто переключить на Native.
Legacy (Default). OpenWebUI не полагается на то, что модель сама «умеет» вызывать нужные инструменты. Данные от всех подключённых инструментов добавляются в общий контекст запроса (обычно подмешиваются в системный промпт), а модель должна уже по ним сгенерировать ответ в ожидаемом формате, который затем парсится. Этот способ работает с любой поддерживаемой моделью, но надёжность переменная: модель может переусложнить вызов, сгенерировать невалидный JSON или просто проигнорировать инструмент.
Native (Agentic). Модели передаётся только список инструментов через специальный API-параметр, а не текстом в промпте. Модель, обученная на формат tool calling, распознаёт параметр и генерирует вызов в структурированном виде. OpenWebUI получает готовый ответ от инструмента и не угадывает, что модель имела в виду.
Если нейросетевые модели семейства Qwen3 отлично работают и в том и другом режиме, то с Gemma 4 Native режим даже для версии it (Instruction-Tuned) требует специализированного подхода. Именно эту работу и берёт на себя пайп (и не только эту).
Почему же не Qwen, а Gemma? Дело в скорости. С отключённым режимом размышления Gemma 4 выдаёт сравнимый (если честно, чуть-чуть похуже) ответ за 5–7 секунд на связке из двух 16 ГБ A4000, а Qwen 3 «думает» по 30–40 секунд.
Pipe (function) и Valves
Pipe (он же function) — это плагин OpenWebUI, который перехватывает запрос до отправки в модель. Технически это Python-класс с методом pipe, который получает тело запроса и возвращает строку, JSON или поток; внутри пайп волен сколько угодно раз ходить в LLM, вызывать MCP-инструменты, править промпт и включать/выключать RAG.
Он превращает «одну модель в интерфейсе» в детерминированный конвейер: пайп отображается в OpenWebUI как отдельная модель, а значит ему можно настроить права, задать свои настройки и вызывать «извне» по API, а на внешних клиентах достаточно заменить в вызове кастомную модель на модель пайпа.
Valves — это настраиваемая часть пайпа, контролирующая, как данные «протекают» через него. Представляет собой вложенный в Pipe класс-наследник BaseModel (плюс отдельный UserValves для пользовательских настроек): он держит конфигурируемые параметры (ключи, URL, пороги), которые сохраняются в БД, показываются в админ-панели и перечитываются на каждом запросе, то есть это «ручки», которыми настраивают поведение пайпа без правки кода через меню.
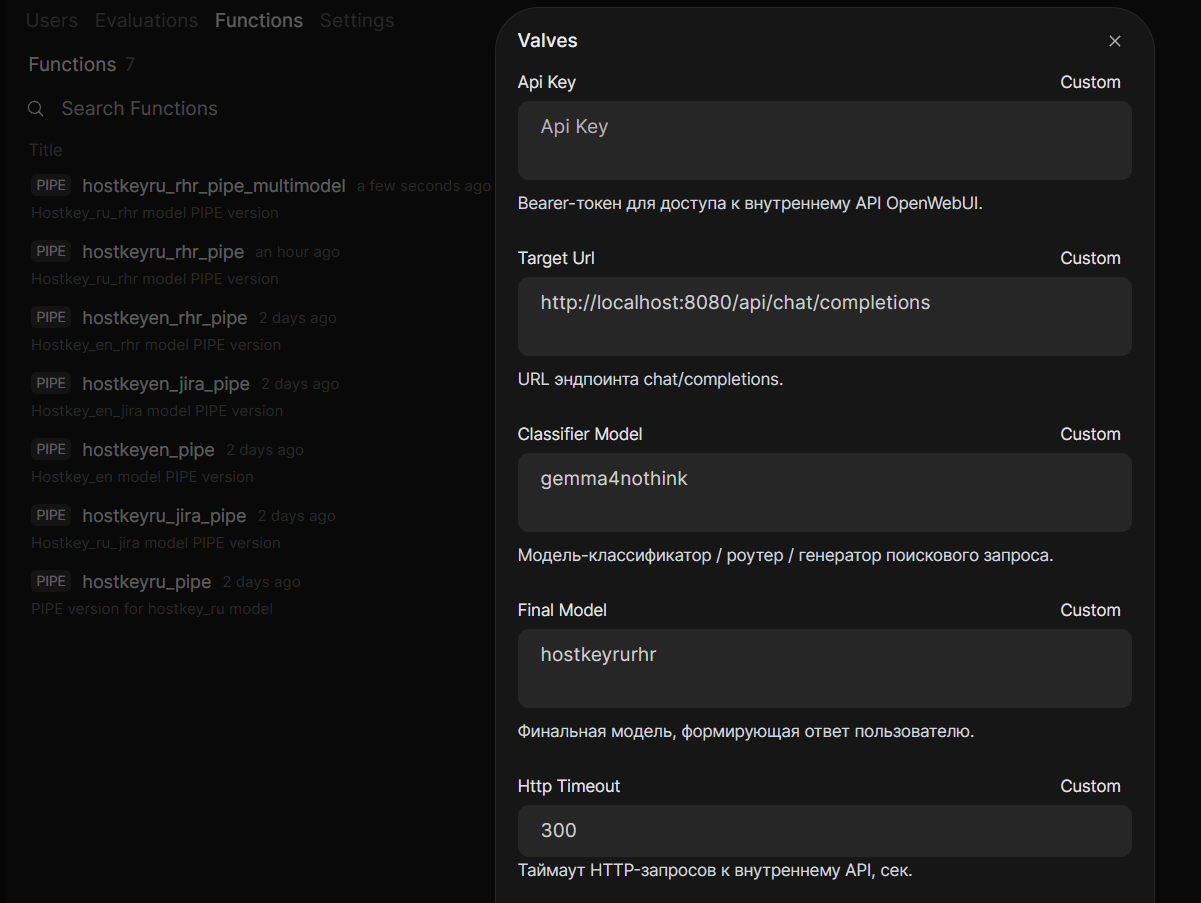
Valves имеют свои ограничения, и некоторые вещи в них выносить не имеет смысла, поэтому мы их в своих пайпах не используем вообще — нам проще переписать промпты и значения параметров в коде пайпа.
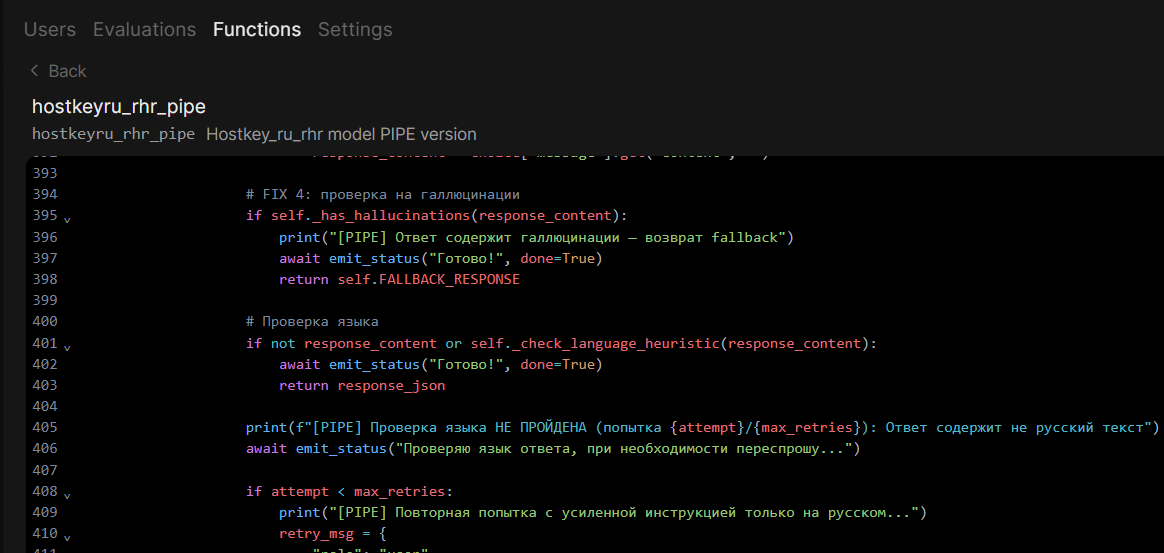
Сами пайпы создаются в разделе Admin Panel - Function.
Почему настроек модели недостаточно
Кроме неработающих вызовов инструментов, вот что нас ещё не устроило в стандартных механизмах OpenWebUI:
- Решение принимает та же модель, что отвечает. Нет разделения ролей на «быстрый роутер» и «модель-ответчик с RAG» и т. п. Всё идёт через одну модель с одними настройками и одним огромным системным промптом, температурой и т. п.
- Нет контроля порядка фаз. Штатный tool calling не гарантирует нужный порядок вызова инструментов. Нам, например, надо было получить сначала поиск по ключевым словам, потом инструменты доступности сервера и MCP Invapi, а уже потом ответ с RAG.
- RAG нельзя отключать для конкретных шагов, например, на время вызова инструментов, чтобы данные не смешивались.
- Нет постобработки — проверки языка, обрезки служебных хвостов, отбрасывания «заглушек», fallback. Это можно попытаться сделать на уровне системного промпта, но срабатывает это не очень хорошо.
- Обязательный ручной разбор tool_calls при вызове через API, так как модель отдаёт голый вызов, а не готовый ответ.
- Пользователь не видит, что происходит внутри конвейера, когда несколько запросов к LLM и MCP-вызовы выглядят как «зависший» интерфейс.
Анатомия пайпа
Разберём пайп на примере hostkeyru_rhr_pipe. Он обслуживает русскоязычную поддержку HOSTKEY: отвечает на вопросы по VPS, документации и типовым проблемам, а инструменты (MCP) подтягивают актуальные данные из систем. Финальная генерация при этом идёт в кастомную модель hostkeyrurhr, то есть пайп перехватывает запрос, делает всю подготовительную работу и уже на последнем шаге отправляет обогащённый промпт в модель с включённым RAG.
Пайп получает от OpenWebUI несколько аргументов. Ключевые: body (сообщения, модель, флаги, tool_ids, features), __tools__ (словарь доступных MCP-инструментов с вызываемыми функциями) и __event_emitter__ (канал статусов в UI):
async def pipe(
    self,
    body: dict,
    __user__: Optional[dict] = None,
    __tools__: Optional[dict] = None,
    __metadata__: Optional[dict] = None,
    __event_emitter__=None,
) -> Union[str, Generator, Iterator, Dict[str, Any]]:
    messages = list(body.get("messages", []))

    if not messages:
        return "Ошибка: пустой запрос."
    user_wanted_stream = body.get("stream", False)
Затем из последнего сообщения пользователя извлекается текст — аккуратно, потому что сообщение может быть мультимодальным (просто текст или список блоков «текст + картинка»):
for i, msg in enumerate(reversed(messages)):
    if msg.get("role") == "user":
        user_msg_index = len(messages) - 1 - i
        original_content = msg.get("content", "")
        if isinstance(original_content, str):
            user_query_text = original_content
        elif isinstance(original_content, list):
            text_parts = [item.get("text", "") for item in original_content if item.get("type") == "text"]
            user_query_text = " ".join(text_parts).strip()
        break
На этом этапе работает только код без привлечения нейросетей.
Отдельно стоит сказать про __event_emitter__. Это аргумент, который OpenWebUI передаёт в пайп. Реализовано все как async-функция, через которую можно отправлять в чат события: промежуточные статусы, уведомления, обновления сообщения.
Пользователь видит их прямо в интерфейсе, где вместо неинформативной «зависшей» полосочки появляется сменяемая лента событий: «Анализирую запрос > Извлекаю ключевые слова > Ищу документацию > Проверяю необходимость вызова инструментов > Использую инструмент > Формирую финальный ответ».
Технически это обёртка над отправкой события типа status:
async def emit_status(description: str, done: bool = False):
    if __event_emitter__:
        await __event_emitter__({
            "type": "status",
            "data": {"description": description, "done": done}
        })
Отображение статуса работы критично для пайпов, внутри которых несколько последовательных запросов к LLM и MCP. Без статусов пользователь не понимает, что происходит, и часто уходит из чата, не дождавшись результата.
Фаза −1. Проверка зоны ответственности RHR: каскад из трёх эшелонов
В изначальном пайпе проверки «это RHR-запрос?» не было вообще. А значит, на запросы «выпишите мне счёт» и на «ssh не работает» приходил одинаковый ответ. Всё это повышало нагрузку на отдел, обслуживающий серверы, поэтому было решено облегчить им работу на этапе ответа бота.
Для этого в новом пайпе hostkeyru_rhr_pipe появилась Фаза −1, и это не один запрос к LLM, а каскад, где каждый следующий эшелон включается только если предыдущий не дал однозначного ответа.
Эшелон 1 — keyword guard (_keyword_prefilter)
Написан на чистом Python, без LLM. Код ищет в тексте два набора маркеров: RHR_KEYWORDS (ssh, перезагруз, raid, сеть, dns, не отвеч…) и CLIENT_SOFTWARE_SIGNALS (код сайта, конфиг nginx, wordpress, laravel…). Если есть только RHR-ключи, ставим значение параметров in_scope=True, edge, 0.9. Если только сигналы софта, то in_scope=False, client_software, 0.9. Если оба или ни одного отдаём None и двигаемся дальше.
Это закрывает типовые обращения без единого запроса к модели.
Эшелон 2 — LLM-классификатор (_classify_rhr_scope + RHR_SCOPE_SYSTEM_PROMPT)
Здесь мы делаем запрос к модели gemma4nothink с температурой равной нулю. В промпт запроса при этом вшиты полный регламент RHR_REGULATION, пять критических правил («грамматическая форма не меняет зону», «KEYWORD GUARD», «client_software требует явных сигналов», «пограничные случаи = edge», «калибровка confidence»), восемь few-shot примеров и строгий формат JSON ответа. Последний парсится и приводится к удобоваримому виду для третьего эшелона. При любой неудаче задаём ответ: in_scope=True, unknown, 0.0.
Эшелон 3 — recheck (_recheck_rhr_scope + RHR_RECHECK_SYSTEM_PROMPT)
Это страховка от ложного отсечения: клиент с реальной проблемой доступа не уйдёт в биллинг. Recheck запускается только если первый проход вернул in_scope=False, категорию client_software или unknown, и confidence попал в диапазон [0.7, 0.85]. Для категорий billing, client_area, legal, sales, abuse (там высокая уверенность) и для edge (там in_scope=True) recheck не запускается.
Пользователь при этом видит сменяемые статусы: «Проверяю зону ответственности Remote Hands…», «Пограничный случай — перепроверяю зону…» (только при recheck), «Запрос вне зоны RHR, добавляю предупреждение» / «Запрос в зоне RHR, продолжаю».
Быстрая карта каскада:
|
Запрос |
Эшелон |
Вердикт |
Что видит пользователь |
|---|---|---|---|
|
ssh не работает |
1 |
True, edge, 0.9 |
Обычный ответ |
|
как починить конфиг nginx |
1 |
False, client_software, 0.9 |
Предупреждение |
|
хочу вернуть деньги |
2 |
False, billing, 0.95 |
Предупреждение |
|
НЕ ПОДКЛЮЧАЙСЯ ПО ssh! |
2 |
True, edge, 0.95 |
Обычный ответ |
|
сайт не работает, ssh тоже |
2→3 |
True, edge, >=0.85 |
Обычный ответ |
|
что-то странное с сервером |
2, fail-open |
True, unknown, 0.0 |
Обычный ответ |
Фаза 0. Предварительный поиск по документации
Первый короткий запрос мы делаем просто к модели gemma4nothink (это базовая модель, но с отключённым размышлением). В нём нам нужно превратить вопрос пользователя в 2–3 ключевых слова для поиска.
Промпт (который мы задаём именно в пайпе, так как модель общего плана) жёстко ограничивает длину запроса, потому что длинные фразы дают плохой поиск:
router_messages = [{
    "role": "system",
    "content": (
        "Перефразируй сообщение пользователя в поисковый запрос из 2-3 слов для поиска по документации HOSTKEY. "
        "Выведи ТОЛЬКО ключевые слова через пробел. Ничего больше. "
        "Хорошо: 'ssh подключение', 'gpu nvidia', 'ip адрес', 'смена ip адреса', 'резервные копии'. "
        "Плохо: 'смена ip адреса или дополнительный ip' (слишком много слов). "
        "Строгое ограничение: 2-3 слова."
    )
}, {"role": "user", "content": user_text}]
Результат: модель формирует нужный нам query, который уходит в MCP-инструмент поиска по документации. По факту мы за пользователя открываем клиентскую доку и вводим наш запрос в строку поиска и забираем первые полученные результаты. Вызов инструмента идёт напрямую (весь MCP-инструментарий «крутится» локально на этом же сервере, где и Ollama с OpenWebUI). В коде есть два пути: сначала инструмент ищется в __tools__ (там же, где его видит OpenWebUI), а если его там нет, то идёт HTTP-фоллбэк на локальный MCP-сервер:
MCP_BASE_URL = "http://host.docker.internal:8000"
tool_path = "/docs_url_ru"
tool_name = "search_hostkey_docs_ru"
url = f"{MCP_BASE_URL}{tool_path}/{tool_name}"
response = await self.client.post(url, json={"query": query, "limit": 5})
Если результат получился слишком коротким (меньше значения docs_retry_threshold, который по умолчанию задан в 400 символов), пайп делает повторный запрос с сырым текстом пользователя, чтобы не потерять релевантные ссылки.
Найденные ссылки сохраняются в docs_result до обращения к основной модели, и это помогает получить как более релевантный ответ, так (что немаловажно) релевантные ссылки на конкретные разделы документации, так как в базе знаний у нас их нет в явном виде.
В статусе пользователь при этом видит три события: «Извлекаю ключевые слова для поиска…» перед запросом к LLM, «Ищу документацию: {query}» перед вызовом MCP и «Документация найдена» после успеха. При ошибке — «Не удалось получить документацию, продолжаю…».
Фаза 1. MCP-роутер
Второй запрос также делаем к gemma4nothink, но теперь как к «роутеру инструментов». Модель предварительно решает, нужен ли тот или иной MCP-инструмент, и при необходимости вызывает его.
Здесь мы используем минималистичный системный промпт:
tool_checking_messages = [
    {"role": "system", "content": (
        "Ты — системный маршрутизатор. Твоя единственная цель — определить, "
        "нужно ли вызвать инструменты MCP под запрос пользователя. "
        "Если инструмент нужен, вызови его немедленно с правильными аргументами. "
        "Если инструменты не нужны, ничего не вызывай и просто напиши: 'skip'.")},
    {"role": "user", "content": user_query_text},
]
Перед выполнением запроса пайп правит его тело: выкидывает knowledge/search-инструменты, оставляет только русскоязычные варианты инструментов, выключает RAG и жёстко подменяет модель:
if "tool_ids" in body and body["tool_ids"]:
    body["tool_ids"] = [t for t in body["tool_ids"] if "knowledge" not in t and "search" not in t]
    body["tool_ids"] = self._filter_tool_ids_by_lang(body["tool_ids"])
body["docs"] = []
if "features" in body:
    body["features"]["retrieval"] = False  # RAG выключен на время работы роутера
body.setdefault("options", {})["temperature"] = 0
body["model"] = "gemma4nothink"
body["stream"] = False
body["messages"] = tool_checking_messages
Ответ разбирается кодом. Аргументы tool_calls парсятся через json.loads, вызываемая функция ищется в __tools__ (с фоллбэком по частичному совпадению имени, потому что имя функции в tool_call и ключ в __tools__ могут не совпадать), результат складывается в итоговую текстовую сводку:
for tc in tool_calls:
    func_name = tc.get("function", {}).get("name")
    func_args_str = tc.get("function", {}).get("arguments", "{}")
    try:
        args = json.loads(func_args_str) if isinstance(func_args_str, str) else func_args_str
    except (json.JSONDecodeError, TypeError):
        args = {}
    callable_func = None
    if __tools__:
        if func_name in __tools__:
            callable_func = __tools__[func_name].get("callable")
        else:
            for key, tool_data in __tools__.items():
                if func_name in key or key.endswith(f"_{func_name}"):
                    callable_func = tool_data.get("callable")
                    break
    if callable_func:
        try:
            if asyncio.iscoroutinefunction(callable_func):
                raw_result = await callable_func(**args)
            else:
                raw_result = callable_func(**args)
            if isinstance(raw_result, dict):
                mcp_data_summary += json.dumps(raw_result, ensure_ascii=False, default=str) + "\n"
            else:
                mcp_data_summary += str(raw_result) + "\n"
        except Exception as e:
            mcp_data_summary += f"[Ошибка MCP]: {str(e)}\n"
Пользователь на этом этапе (если он в чате) видит перед запросом сообщение «Проверяю необходимость вызова инструментов…», а перед каждым вызовом MCP: «Использую инструмент: {func_name}». При ошибке же получает текст: «Ошибка инструмента: {текст}».
Если инструмент вообще не нашёлся в __tools__ (например, модель gemma4nothink не видит этот инструмент в OpenWebUI), то пайп тоже ничего не вызывает, и финальный ответ строится только на RAG. Поэтому важное замечание: одни и те же инструменты должны быть подключены как к общей модели, так и к специализированной! Иначе роутер просто не сможет их вызвать.
Фаза 2. Обогащение промпта
Здесь почти нет нейросетей. На этом этапе мы выполняем склейку итогового промпта в коде. Если данные от инструментов есть, в сообщение добавляются и они, и документация, и инструкция; если инструменты не нужны, то только документация. Если и её нет, то лишь требование отвечать по-русски, чтобы не получить ответ на английском или китайском:
strict_ru_instruction = (
    "\n\n[СТРОГАЯ ИНСТРУКЦИЯ: Сформируй итоговый ответ ИСКЛЮЧИТЕЛЬНО на русском языке. "
    "Не используй английский, китайский, арабский или любой другой язык. "
    "Сохраняй профессиональный стиль службы поддержки.]"
)
if mcp_data_summary and user_msg_index != -1:
    enriched_text = (
        f"\n\nПользователь спрашивает: {user_query_text}\n\n"
        f"АКТУАЛЬНЫЕ ДАННЫЕ ИЗ СИСТЕМЫ INVAPI (MCP TOOL RESULT):\n{mcp_data_summary}\n\n"
        f"РЕЛЕВАНТНАЯ ДОКУМЕНТАЦИЯ:\n{docs_result}\n\n"
        f"Инструкция: Сформируй итоговый ответ для пользователя. Полностью опирайся на данные из системы INVAPI выше и на документы из твоей встроенной Базы Знаний (RAG)."
        f"{strict_ru_instruction}"
    )
    if isinstance(original_content, list):                # не ломаем блок со скриншотом
        original_content.append({"type": "text", "text": enriched_text})
    else:
        messages[user_msg_index]["content"] = f"{original_content}{enriched_text}"
Инструкция про русский язык добавляется к сообщению ровно один раз: либо внутри enriched_text, либо отдельным блоком, если обогащения не было.
На этом этапе важно стереть следы инструментов и вернуть RAG:
if "tools" in body: del body["tools"]
if "tool_ids" in body: del body["tool_ids"]
if "docs" in body: del body["docs"]
if "features" in body: body["features"]["retrieval"] = True   # возвращаем RAG обратно
body["model"] = "hostkeyrurhr"
Фаза 3. Финальная генерация
В этой фазе основной запрос идёт уже к кастомной модели hostkeyrurhr с включённым RAG и стримингом, если его запросил пользователь:
messages.insert(0, {
    "role": "system",
    "content": (
        "КРИТИЧЕСКОЕ ПРАВИЛО: Ты ДОЛЖЕН отвечать ТОЛЬКО на русском языке. "
        "Никогда не используй английский, китайский, арабский или любой другой язык. "
        "Если ты в чём-то не уверен, отвечай на русском. "
        "Это обязательное требование — нарушения недопустимы."
    )
})
body["messages"] = messages
body["stream"] = user_wanted_stream
final_response = await self._post_with_retry(body, headers)
В этой фазе пользователь увидит «Формирую финальный ответ…». Это последняя «долгая» стадия, и до её завершения пользователь видит, что конвейер ещё работает.
Фаза 4. Постобработка: проверка языка, вырезание заглушек и fallback
Это тот слой, которого в настройках OpenWebUI нет вообще. В нём готовый ответ проходит через код на регулярных выражениях.
Первым делом мы ищем кириллицу, и если её нет, а латиница есть — считаем, что ответ не на русском и его надо переделать или выдать fallback.
def _check_language_heuristic(self, text: str) -> bool:
    if not text or not text.strip():
        return True
    cyrillic_pattern = re.compile(r'[\u0400-\u04FF]', re.UNICODE)
    cleaned = re.sub(r'```[\s\S]*?```', '', text)
    cleaned = re.sub(r'`[^`]+`', '', cleaned)
    cleaned = re.sub(r'https?://\S+', '', cleaned)
    if cyrillic_pattern.search(cleaned):
        return True
    latin_pattern = re.compile(r'[A-Za-z]', re.UNICODE)
    if latin_pattern.search(cleaned):
        print("[PIPE] Проверка языка НЕ ПРОЙДЕНА: Кириллица не обнаружена, вероятно не русский язык")
        return False
    return True
Инлайн-код и ссылки перед проверкой вырезаются, чтобы не ловить ложные срабатывания на технических терминах вроде SSH, IP, VPS. При провале делаем повтор запроса с усиленной инструкцией, а после исчерпания попыток выводим русский fallback вместо технической ошибки.
Повтор устроен так: в messages добавляется напоминание, что предыдущий ответ содержал не русский текст, и запрос повторяется. Если после всех попыток язык так и не русский — возвращается FALLBACK_RESPONSE.
Помимо проверки языка, постобработка делает ещё две важные вещи, о которых стоит сказать отдельно.
Вырезание хвостовой фразы «Продолжить»
Финальная модель добавляет в конец ответа приглашение «Если ваш вопрос не решён и его нужно отправить нашим сотрудникам, то нажмите "Продолжить" для отправки». Эта фраза зашита и в системном промпте, и в fallback-заглушке, поэтому в ответе она может дублироваться или она вообще не нужна, если запрос не относится к HR. Значит, её надо вырезать.
Проблема в том, что в пайпе мы не знаем заранее, будет ли эта фраза в конце, и просто отрезать последние N символов нельзя. Поэтому пайп придерживает определенное число символов (длина самой длинной оконечной фразы + запас) и отдаёт их только тогда, когда уверен, что это не конец ответа. Хвост проверяется через _strip_prompt_footer с нормализацией кавычек и регистра.
Вырезание абзацев-заглушек
Если ответ короткий (меньше 800 символов) и в первых 400 символах найден маркер fallback-заглушки (FALLBACK_MARKERS) («изучения нашими специалистами», «нажмите "продолжить"», «передать проблему нашей команде» и т. п.), пайп режет ответ по абзацам и выбрасывает те, что содержат маркер. Это защита от случая, когда модель сама вставила в ответ шаблон-заглушку, хотя вопрос был в зоне RHR.
По итогу мы получаем ответ на наш запрос с предупреждением и советом. Да, еще не совсем идеально, и есть над чем работать.
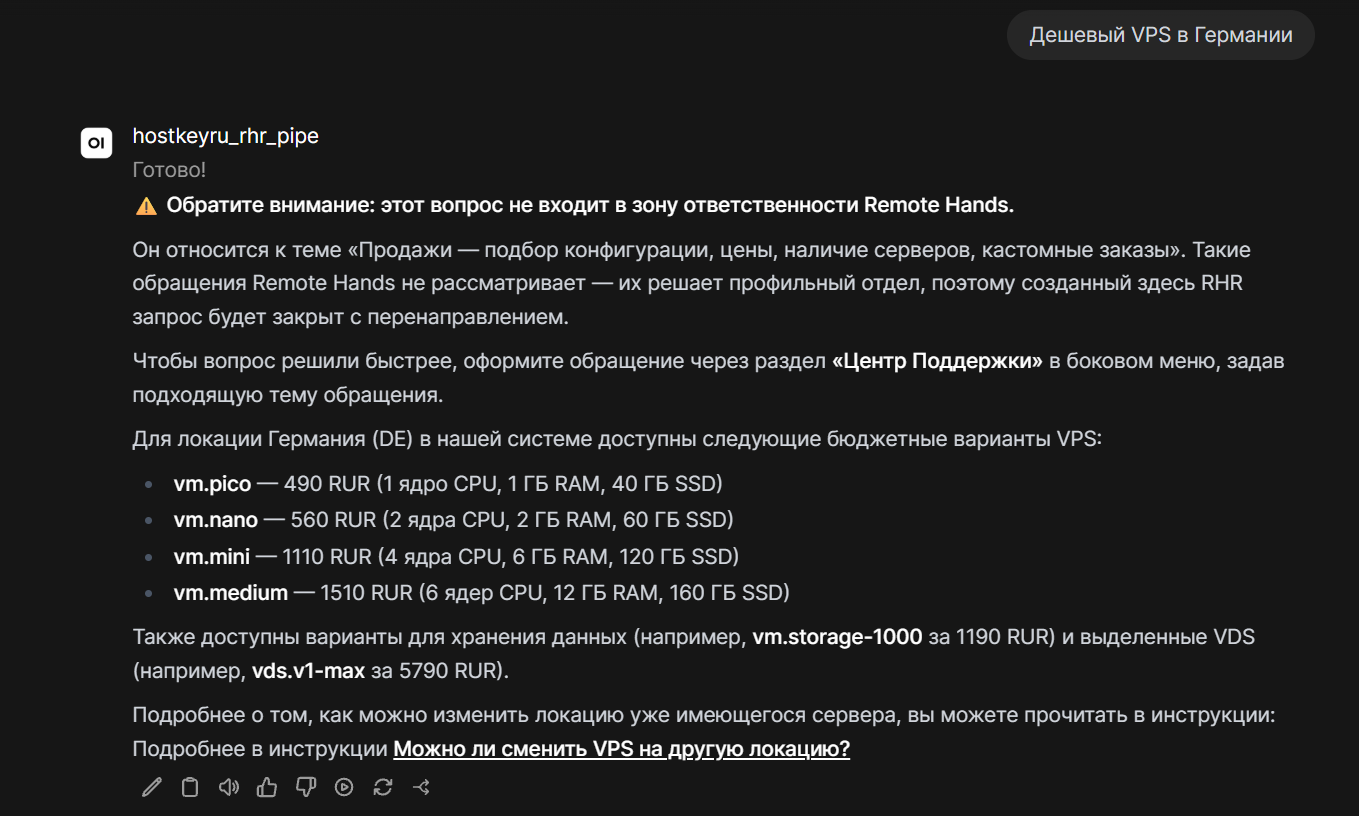
По скорости пайпа мы теряем дополнительно от 5 до 10 секунд на ответ для дополнительных запросов к LLM, но в нашем случае это не сильно критично, и вместо 5-10 секунд ответ выводится через 10-20 секунд, что для нашего железа и модели очень хороший результат.
Проблемы с пайпом
Честно скажем: пайп — это не просто плагин с настройками, а код, который надо поддерживать. И любые изменения требуют в нем правок.
- Сигнатура pipe() и формат __tools__ — часть контракта OpenWebUI. При обновлении среды они могут меняться, и пайп придётся адаптировать.
- Отладка сложнее, чем настройки модели. Вместо одного промпта (в нашем случае) мы получаем пять фаз, три запроса к LLM, вызовы MCP и постобработку.
- Пайп не отменяет нормального RAG и системных промптов с гибкой настройкой кастомных моделей. Он лишь даёт контроль над порядком фаз и гарантирует, что инструменты вызовутся и данные не смешаются с RAG. Если база знаний пустая или промпты плохие, то пайп вас не спасёт.
- Одни и те же инструменты должны быть подключены и к общей модели, и к специализированной. Иначе роутер их не увидит и молча пропустит вызов.
Подведем итоги
Настройки кастомной модели в OpenWebUI до сих пор остается самым простым и быстрым способом использовать базу знаний, подключить инструментарий и провести тонкую настройку вызова модели, но для боевой поддержки этого, увы, уже недостаточно.
Штатный инструмент не гарантирует порядок вызовов (а через API и автоматически часто не может вызвать инструментарий вообще), не даёт «погасить» RAG на время работы инструментов, не разделяет роли «роутер» и «ответчик» и не делает постобработку.
Пайп превращает «одну модель в интерфейсе» в детерминированный конвейер: keyword guard и LLM-классификатор отсекают запросы вне зоны ответственности, отдельный шаг ищет документацию, другой — вызывает MCP-инструменты с выключенным RAG, финальная модель же получает уже обогащённый промпт, а постобработка проверяет язык, вырезает служебные хвосты и заглушки и подстраховывает fallback-ответом.
Именно такая схема с разделением фаз, явным управлением RAG и постобработкой позволяет нам держать ботов техподдержки предсказуемыми: данные из систем не смешиваются с пересказом документации, инструментарий срабатывает в нужный момент, а ответы приходят на нужном языке.
Закажите сервер с персональным AI-чат-ботом на вашем собственном сервере.