

 Помощь
 Документация

 Вход


Генеративные модели сейчас стали как никогда популярны в России и за её пределами. Конечно люди относятся к ним по разному: кого-то они бесят, кто-то в восторге от новых возможностей в решении повседневных задач и в творчестве, кто-то испытывает страх из-за рисков потери работы. Бытует и совсем уж иррациональная точка зрения, что все неумолимо движется к апокалипсису. Однако работать с генеративными моделями так или иначе придется практически всем. Сегодня мы рассмотрим два подхода к организации труда и сравним LiteLLM и OmniRoute. Это популярные шлюзы с открытым кодом, скрывающие десятки поставщиков языковых моделей за одним адресом, совместимым с API OpenAI.
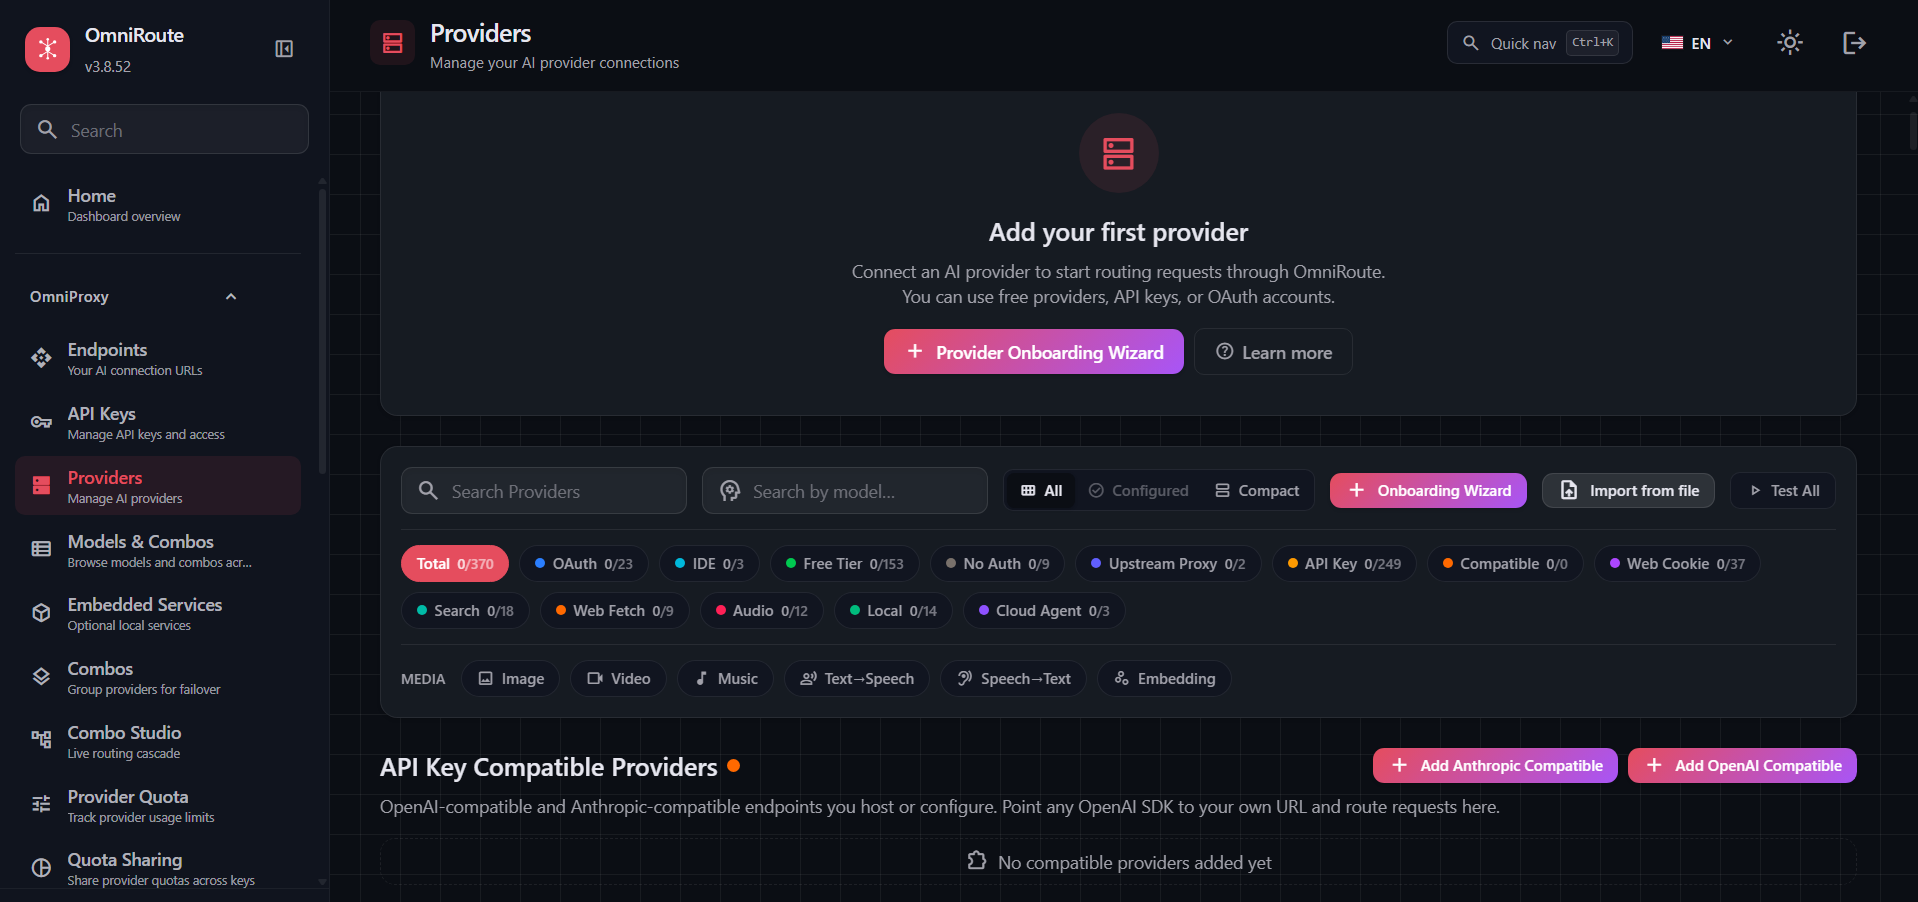
На странице OmniRoute более 370 поставщиков: от платных API до бесплатных тарифов и подписок
Закажите сервер с уже установленным LiteLLM или OmniRoute и подключите свои модели сразу после запуска.
Коротко о результатах
Мы измеряли сколько шлюзы добавляют к запросу, какое количество запросов в секунду выдерживают и какой объем памяти и процессора тратят.
С одним рабочим процессом LiteLLM выигрывает на обычных запросах, а на потоковой выдаче (стриминге) впереди OmniRoute, если выключить в нем защиту от лимитов. Стоит дать LiteLLM второй рабочий процесс - он обгоняет соперника в обоих режимах, поскольку OmniRoute второе ядро задействовать не умеет.
|
LiteLLM, 1 процесс |
LiteLLM, 2 процесса |
OmniRoute |
|
|
Потолок без потоковой выдачи, запросов в секунду |
71 |
130 |
36 (оценка для одинакового железа около 56) |
|
Потолок с потоковой выдачей, запросов в секунду |
20 |
38.5 |
25 (оценка для одинакового железа около 37) |
|
Добавка к одному обычному запросу, миллисекунд |
14 |
15 |
30 |
|
Пик памяти шлюза, гигабайт |
0.9 |
2.1 |
1,2 |
|
Годятся ли настройки по умолчанию для своей модели |
да |
да |
нет, около 1 запроса в секунду |
Зачем нужен шлюз перед языковыми моделями
Когда приложение взаимодействует с одной моделью от конкретного поставщика, шлюз не требуется. Но если поставщиков становится двое, а потребителей модели — пятеро, удобнее использовать один адрес с единым форматом API. Шлюз самостоятельно определяет, куда направить запрос. Через него команды и сервисы получают отдельные ключи, лимитируются бюджеты, при сбое основной модели включается резервная, и централизованно отслеживаются расходы на работу с моделями. По сути, шлюз служит удобным координатором.
Недостаток такого подхода вытекает из его удобства, т.к. в цепочке появляется лишнее звено и точка возможного отказа. Ответ языковой модели занимает секунды, и на этом фоне десятки миллисекунд на шлюзе незаметны, но при сотне одновременных клиентов очередь копится, а модель за ним может простаивать. В нашем тесте модель заменена мгновенной заглушкой, и все измеренное время приходится на сам шлюз.
Чем LiteLLM и OmniRoute отличаются по устройству
Оба шлюза отдают один адрес, совместимый с API OpenAI, однако выросли из разных задач. Это заметно по тому, что у каждого внутри. LiteLLM обычно ставит команда инженеров перед всеми внутренними сервисами компании. Каждый сервис получает свой ключ с месячным лимитом в долларах, а расходы по всем ключам собираются в Postgres. Такой подход позволяет увидеть расходы каждого подразделения. OmniRoute скорее адаптирован под одного разработчика, работающего с Claude Code, Codex или Cursor и желающего подключить к ним разом свои подписки. Когда у одного поставщика заканчивается квота, OmniRoute сам отправляет следующий запрос другому - агент продолжает работать без перенастройки.
|
LiteLLM |
OmniRoute |
|
|
Язык и среда выполнения |
Python, FastAPI |
TypeScript, Next.js на Node.js |
|
Хранилище |
Postgres (ключи, бюджеты и журнал расходов) |
Redis и локальный каталог данных |
|
Кто и зачем ставит |
Команда инженеров для внутренних сервисов компании |
разработчик для своих агентов |
|
Маршрутизация |
маршрутизатор с повторами и резервными моделями |
“комбо”, то есть цепочки моделей с автоматическим переключением, и модели auto |
|
Масштабирование |
флаг --num_workers и несколько экземпляров |
один процесс Node.js |
Тестирование
Готовые тесты производительности нашлись только для LiteLLM, и важный нюанс состоит в том, что сделаны они были разработчиками шлюза. По их данным четыре экземпляра LiteLLM на заглушке, имитирующей API OpenAI, держат около 1 170 запросов в секунду и добавляют к запросу 8 миллисекунд на 95-м перцентиле. Независимое сравнение от команды agentgateway показало больше фактуры. Под нагрузкой LiteLLM занял почти 12 гигабайт памяти при 18 рабочих процессах. Для OmniRoute опубликованных тестов мы не нашли. Поэтому мы собрали стенд из двух виртуальных серверов. На каждом работали три программы: сам шлюз, клиент, который создает нагрузку, и заглушка, имитирующая языковую модель. Шлюзу мы выделили два ядра процессора, клиенту и заглушке по одному, чтобы они не забирали процессорное время у шлюза и не искажали результаты теста.
|
Сервер LiteLLM |
Сервер OmniRoute |
|
|
Процессор |
4 виртуальных ядра, AMD EPYC 7542 |
4 виртуальных ядра, AMD EPYC 7702P |
|
Память и подкачка |
7,7 Гб, без подкачки |
7,7 Гб, подкачка 4 Гб |
|
Система |
Ubuntu 24.04 |
Ubuntu 24.04 |
|
Установка |
Docker, Postgres 16 |
Docker, Redis 8, лимит памяти контейнера 4,6 Гб |
Схема теста следующая:
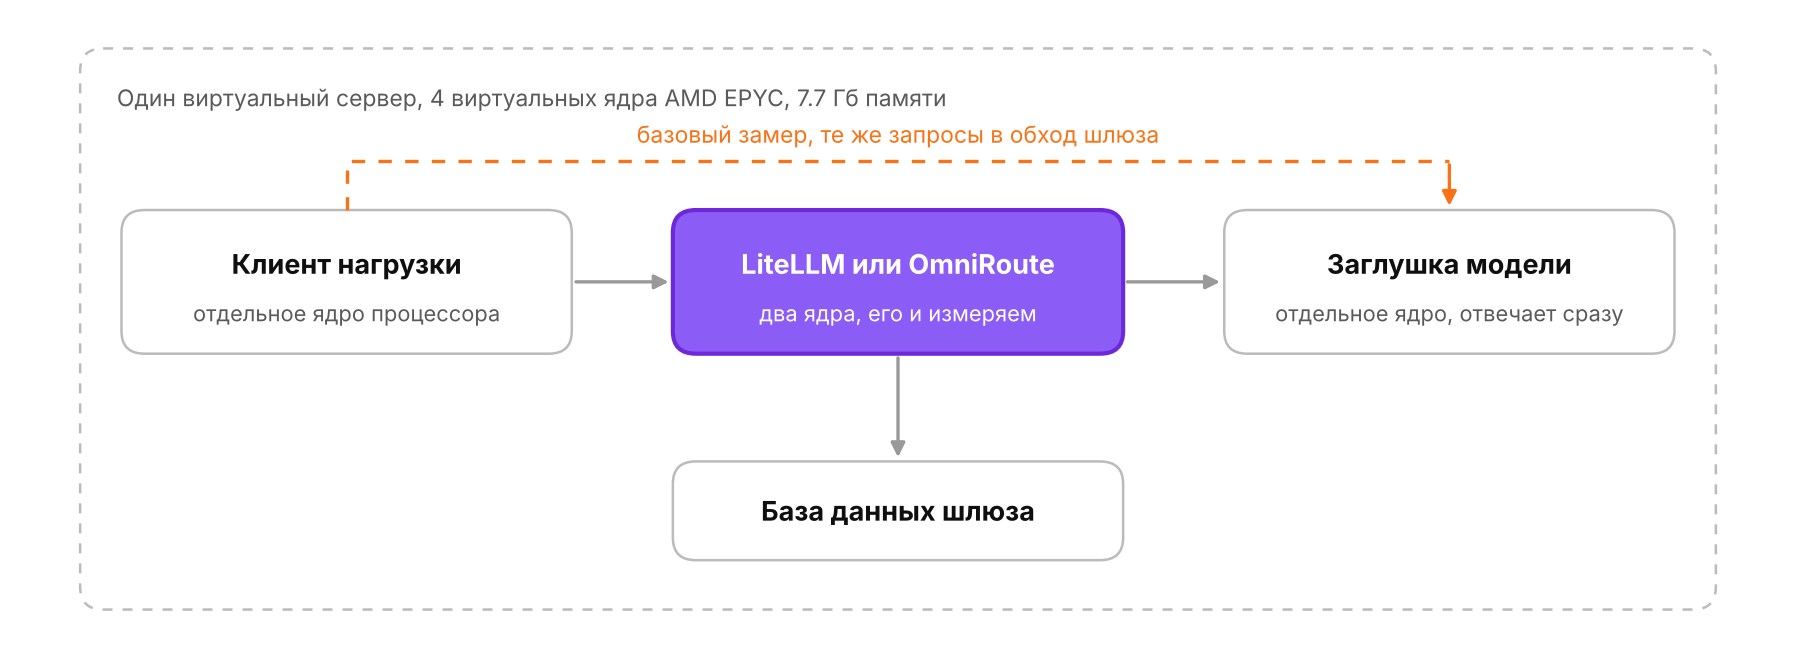
Шлюз, клиент и заглушка стоят на одном сервере и на разных ядрах
Заглушка модели работает в отдельном контейнере Docker в одной сети со шлюзом и отвечает на любой запрос сразу, возвращая 50 токенов либо одним ответом, либо пятьюдесятью фрагментами потоковой выдачи. Запросы ходили только внутри сервера, так что сеть между машинами на результат не влияла, и открывать наружу ничего не пришлось.
Перед замером каждого шлюза клиент отправлял те же самые запросы напрямую в заглушку. Такой базовый замер показывает, сколько запросов в секунду выдерживают сами клиент и заглушка на конкретном сервере, и все, что сверх этого, приходится на шлюз. Без базового замера сравнивать результаты двух серверов было бы нечестно, поскольку сервер OmniRoute, как выяснилось, примерно в полтора раза медленнее.
Клиент нагрузки ведет себя как обычное приложение, которое ждет ответа модели. Он отправляет запрос, дожидается ответа целиком и только потом отправляет следующий. Из-за этого при перегрузке шлюза растет в первую очередь время ожидания, а ошибки появляются, только если шлюз сам начинает отказывать в обслуживании, как это случилось с OmniRoute на настройках по умолчанию.
Нагрузку подавали ступенями, сначала один клиент, затем 10, 50, 100 и 200 одновременно: по 30 секунд на ступень и с коротким прогревом перед каждой, отдельно для обычных и для потоковых ответов. Раз в секунду мы записывали загрузку процессора и расход памяти каждого контейнера. Оба шлюза мы оставили в том виде, в каком их обычно разворачивают по инструкции. LiteLLM работает одним рабочим процессом и хранит данные в Postgres, OmniRoute использует Redis. Мы тестировали LiteLLM 1.106.0 из образа main-stable и OmniRoute 3.8.52, а клиент нагрузки и заглушка написаны на Python 3.12. Каждый шлюз мы прогнали дважды, OmniRoute с защитой от лимитов и без нее, LiteLLM с одним и с двумя рабочими процессами.
Насколько шлюз замедляет одиночный запрос
Если клиент один и нет очереди, то LiteLLM добавляет к обычному запросу 14 миллисекунд, OmniRoute 30. На потоковом ответе из 50 фрагментов разница почти исчезает, добавка выходит 45 и 40 миллисекунд. Если вычесть добавку на обычном ответе из добавки на потоковом и поделить на 50, у LiteLLM получится примерно 0.6 миллисекунды на фрагмент, у OmniRoute 0.2, то есть в 3 раза меньше. Оценка эта грубая, поскольку часть времени может уходить на сам запуск потоковой передачи, а ответы мы проверяли только одной длины. При таком расходе ответ живой модели на 500 токенов LiteLLM удлинит примерно на 0.3 секунды, а OmniRoute примерно на 0.1.
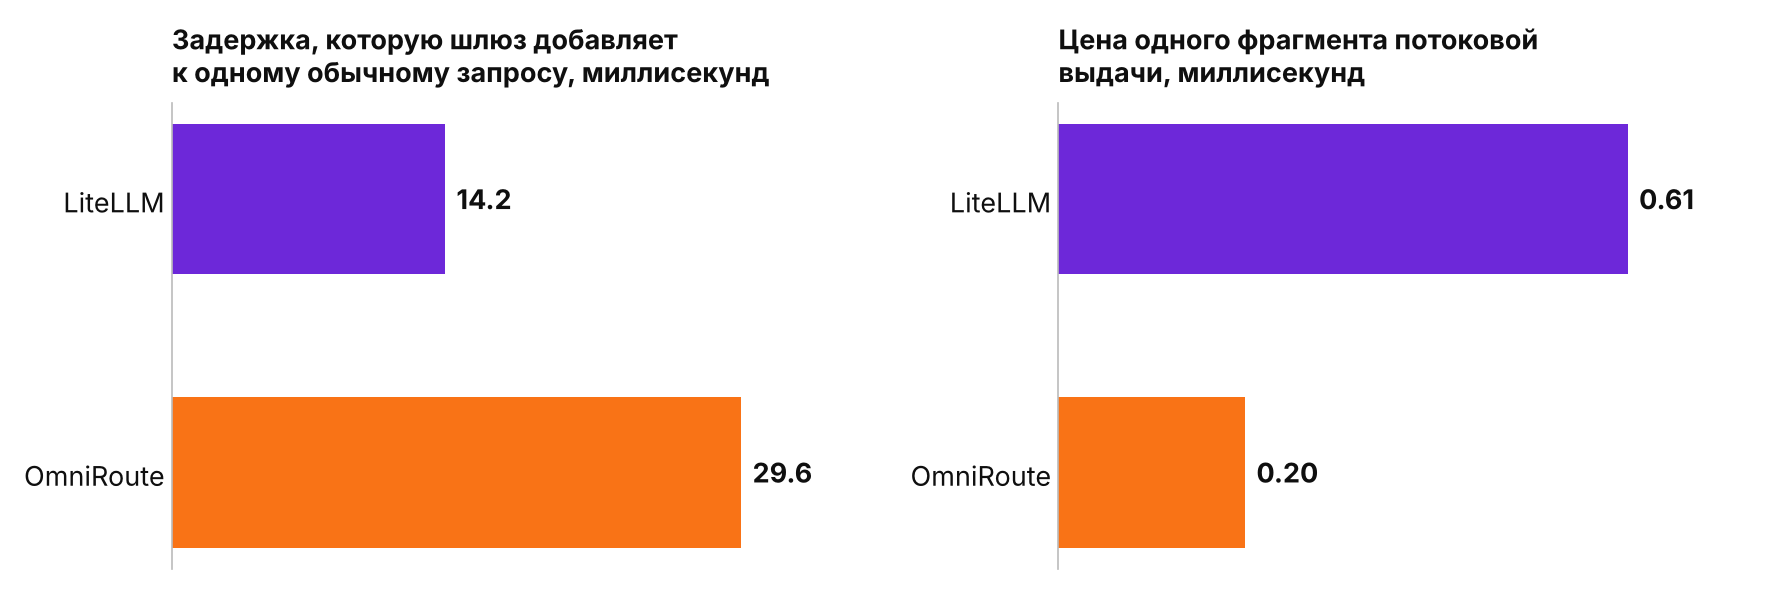
Сам запрос дешевле обрабатывает LiteLLM, а каждый фрагмент потоковой выдачи дешевле у OmniRoute.
Пропускная способность под нагрузкой
Оба шлюза выходят на свой потолок уже при десяти одновременных клиентах, и дальше растет только очередь. LiteLLM с одним рабочим процессом держит 71 обычный запрос в секунду против 36 у OmniRoute с выключенной защитой от лимитов, а на потоковой выдаче уступает ему, 20 против 25.
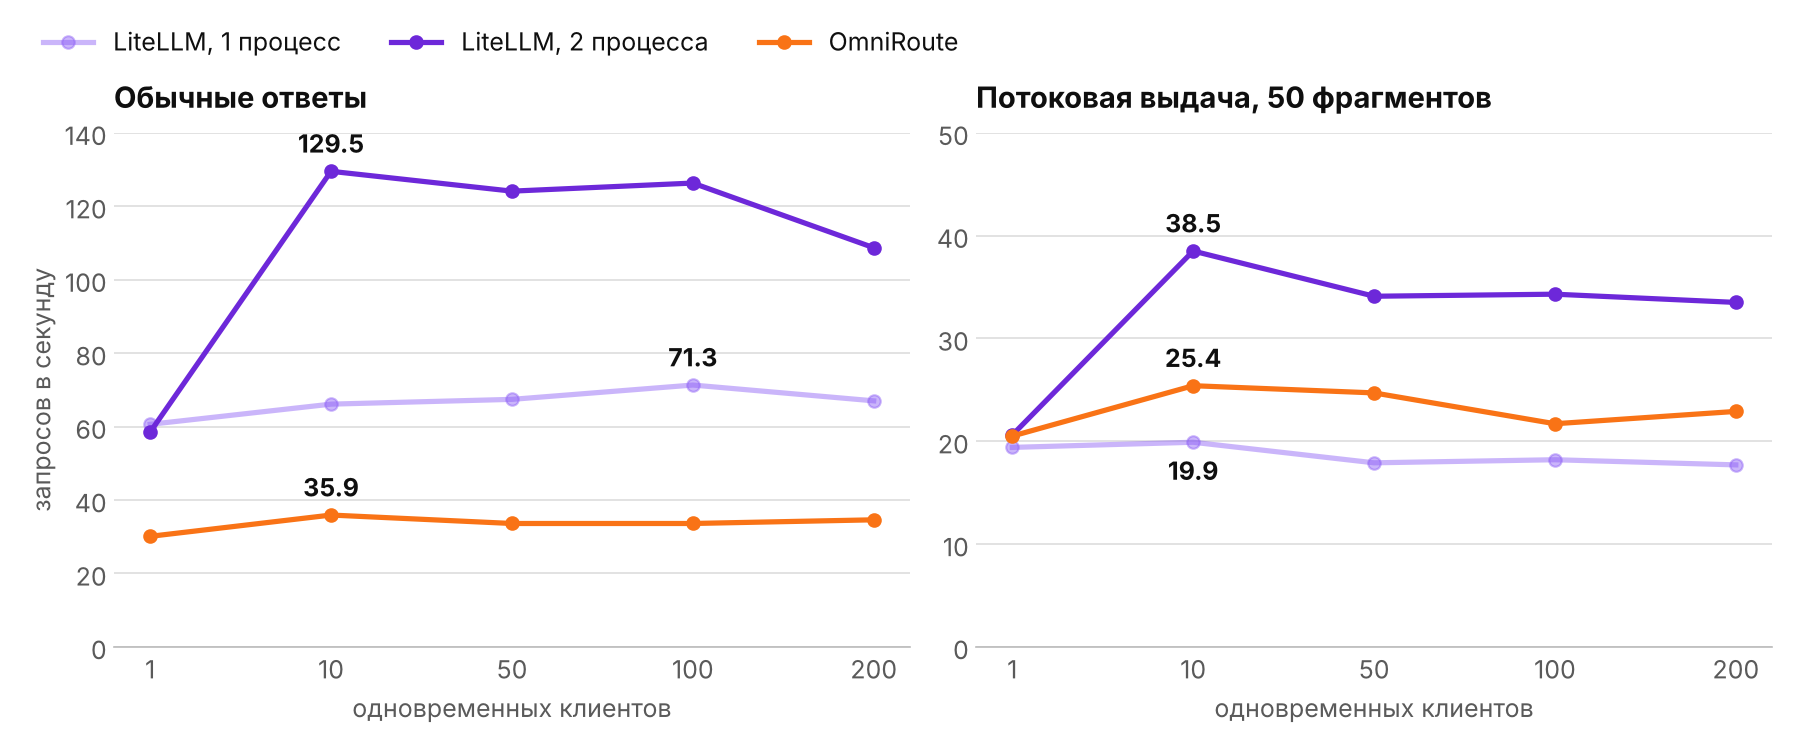
Со вторым рабочим процессом LiteLLM обгоняет OmniRoute в обоих режимах. Шлюзу выделено два ядра, сервер OmniRoute примерно в полтора раза медленнее, поправка на железо описана в разделе об ограничениях тестирования.
Шкалы у двух половин графика разные, слева до 140 запросов в секунду, справа до 50, поэтому линии на одной высоте означают разные числа. Потоковый ответ обходится шлюзу дороже обычного, поскольку вместо одного ответа он пропускает пятьдесят отдельных фрагментов. Для LiteLLM с одним процессом это заметно сильнее, потоковых запросов он пропускает в 3.5 раза меньше, чем обычных, 20 против 71, тогда как у OmniRoute разница всего в 1.4 раза - 25 против 36. Если LiteLLM запускают с двумя рабочими процессами, потолок растет до 130 обычных и 38.5 потоковых запросов в секунду, то есть почти вдвое в каждом режиме, так что на обычных ответах LiteLLM уходит далеко вперед, а на потоковых догоняет OmniRoute даже с поправкой на железо.
Если шлюз уже работает на пределе, каждый новый клиент просто удлиняет очередь, и задержку можно приблизительно определить заранее, разделив число клиентов на пропускную способность. LiteLLM с одним процессом пропускает около 18 потоковых запросов в секунду, значит при 200 клиентах каждому придется ждать примерно 11 секунд (200/18). В нашем тесте половина запросов действительно выполнялась дольше 10.6 секунды. У OmniRoute по той же логике выходит около 9 секунд при измеренных 8.5, у LiteLLM с двумя процессами около 6 секунд при измеренных 5.8.
Сильнее всего шлюзы расходятся на самых медленных запросах. Если взять обычные ответы и посмотреть на один процент запросов, которые ждали дольше всех, у OmniRoute при 100 и 200 клиентах такие запросы выполнялись 30 и 35 секунд. У LiteLLM с одним процессом те же самые медленные запросы занимали 4.5 секунды при 100 клиентах и 13.6 секунды при 200. Похоже, OmniRoute обслуживает очередь менее равномерно, поэтому часть запросов ждет в ней намного дольше остальных.
Без защиты от лимитов ошибок почти не было. Единственное исключение дал LiteLLM с двумя процессами на 200 клиентах, где из 3 420 запросов у двух оборвалось соединение, то есть 0.06%.
Один рабочий процесс занимает одно ядро
Docker считает загрузку процессора так, что 100 % соответствуют одному полностью занятому ядру, а при двух выделенных ядрах предел равен 200 %. Оба шлюза с настройками по умолчанию под нагрузкой держались около 100 %, то есть работали на одном ядре, а второе простаивало. Максимальная пропускная способность LiteLLM с одним процессом и OmniRoute из предыдущего раздела показывает возможности одного ядра, и только LiteLLM с двумя процессами загрузил оба ядра, дойдя до 205 %.
|
Пик под нагрузкой |
LiteLLM, 1 процесс |
LiteLLM, 2 процесса |
OmniRoute |
|
Процессор шлюза, медиана и пик (%) |
102 и 116 |
110 и 205 |
106 и 154 |
|
Память шлюза на старте и в пике (Мб) |
672 и 910 |
1 713 и 2 104 |
489 и 1 154 |
|
Хранилище, память в пике (Мб) |
Postgres, 200 |
Postgres, 351 |
Redis, 9 |
|
Хранилище, процессор в пике (%) |
41 |
95 |
14 |
В образе Docker LiteLLM по умолчанию запускается одним процессом Python. С флагом `--num_workers 2` шлюз запускает второй процесс и пропускная способность вырастает почти вдвое, с 71 до 130 обычных запросов в секунду. Каждый процесс держит в памяти свою копию шлюза, так что потребление выросло с 0.9 до 2.1 Гб. У agentgateway LiteLLM с 18 процессами занял около 12 Гб, то есть примерно 0.7 Гб на процесс.
Также на каждый запрос LiteLLM пишет строку в журнал расходов, поэтому вместе со шлюзом нагружается и Postgres. С двумя процессами база в пике занимала почти целое ядро, а на сервере с четырьмя ядрами это много. При выборе числа процессов эту нагрузку стоит учитывать - возможно необходимо вынести базу на отдельный сервер.
OmniRoute обрабатывает запросы в одном потоке Node.js, а загрузка выше 100 %, до 154, приходится на служебные потоки среды выполнения. Аналога `--num_workers` у OmniRoute мы не нашли, поэтому масштабировать его, по всей видимости, придется несколькими экземплярами за балансировщиком нагрузки. Такую схему мы не проверяли.
Защита от лимитов в OmniRoute
В работе шлюзов есть нюансы. Первый прогон OmniRoute на тестовой машине выдал один запрос в секунду, каждый одиночный запрос проходил через шлюз за 350 миллисекунд, при этом заглушка модели за шлюзом отвечала за две. Процессор контейнера при этом простаивал, так что задержку шлюз создавал самостоятельно. Причина такого поведения нашлась не сразу. Панель управления OmniRoute не отличается лаконичным дизайном и неприметный значок “Protected” существенно помешал работе.
С настройками по умолчанию OmniRoute пропускал около одного запроса в секунду, держал запросы в очереди до 74 секунд, а при 100 и 200 одновременных клиентах начал отвечать ошибками 502, 503 и 429.
|
Нагрузка |
Обычные ответы |
Потоковая выдача |
|
1 клиент |
1 запрос в секунду, медиана 350 миллисекунд |
2.9 запроса в секунду, медиана 350 миллисекунд |
|
10 клиентов |
1 запрос в секунду, 95-й перцентиль 39.8 секунды |
1 запрос в секунду, 95-й перцентиль 42.8 секунды |
|
50 клиентов |
1.3 запроса в секунду, медиана 51.5 секунды |
1.3 запроса в секунду, медиана 51.7 секунды |
|
100 клиентов |
0.7 запроса в секунду, 40 процентов ошибок 502 |
1.5 запроса в секунду, 95-й перцентиль 66.8 секунды |
|
200 клиентов |
все запросы с ошибками 503 и 429 |
3 запроса в секунду, 95-й перцентиль 73.4 секунды |
350 миллисекунд на одиночный запрос навели на мысль о намеренной паузе - задержки были одинаковыми. Половина одиночных запросов выполнялась быстрее 350 миллисекунд, 95 процентов быстрее 358.2, то есть разброс почти нулевой. У шлюза, который просто долго обрабатывает запрос, время от запроса к запросу заметно колеблется. Загрузка процессора это подтвердила, контейнер OmniRoute во время прогона занимал около 20 процентов одного ядра и большую часть времени просто ждал.
Паузы добавляет защита от превышения лимитов (rate-limit protection). В панели управления она отмечена значком "Protected" и включается автоматически для всех поставщиков с ключом API, в том числе для нашей заглушки.
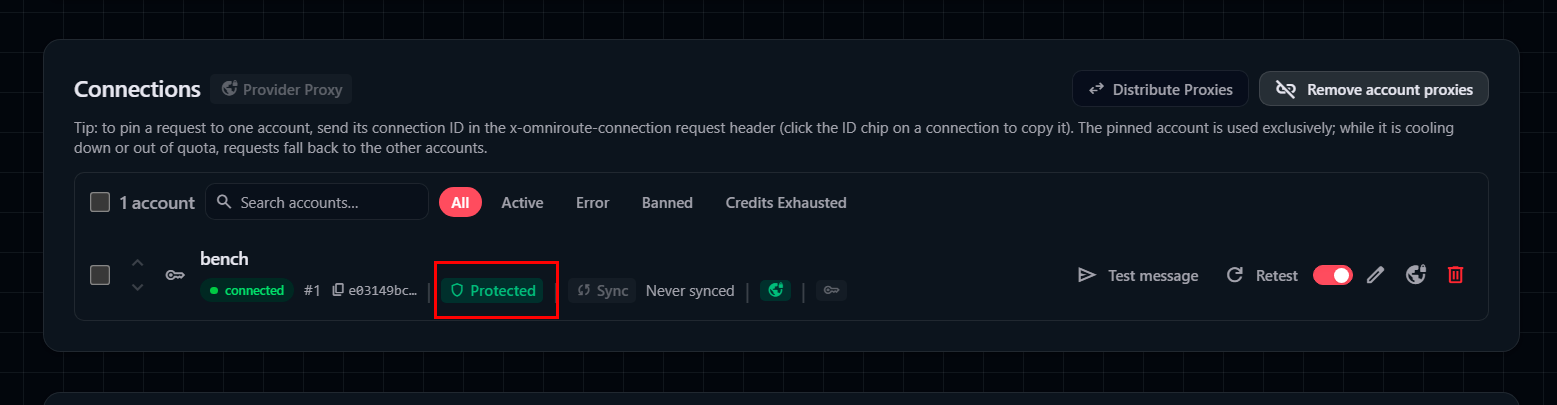
Подключение к заглушке в панели OmniRoute, значок “Protected” в середине строки.
Переключатель в настройках подключения защиту не отключает, для этого необходимо выключить ее для всего шлюза с помощью переменной окружения `RATE_LIMIT_AUTO_ENABLE=false`:
   omniroute:
     environment:
       - RATE_LIMIT_AUTO_ENABLE=false
После перезапуска контейнера одиночный запрос стал выполняться за 31.5 миллисекунды вместо 350, ошибки пропали, и все остальные цифры OmniRoute в статье сняты именно так. OmniRoute создавали в первую очередь для работы с бесплатными тарифами, где за слишком частые запросы блокируют аккаунт, и там защита полезна. Если же за шлюзом стоит своя модель, развернутая на собственном сервере, или платный API, защиту имеет смысл выключить.
Ограничения тестирования
Шлюзы стояли на разных серверах, и сервер OmniRoute оказался примерно в полтора раза медленнее. Поправку на железо мы считали по базовым замерам, в 1.45 раза для потоковых ответов и в 1.56 раза для обычных. И тут еще одно ограничение. В базовом замере участвовали только клиент и заглушка, написанные на Python, тогда как OmniRoute работает на Node.js, и насколько точно поправка переносится на другую среду выполнения, сказать сложно.
Нагрузка синтетическая, с запросом в 200 слов, ответом в 50 токенов и одной заглушкой вместо реальной модели. Переключение на резервные модели, повторы, кэш, цепочки моделей OmniRoute и маршрутизатор LiteLLM в тест не попали.
Итоги. Какой шлюз выбрать
По скорости LiteLLM с двумя рабочими процессами выигрывает у OmniRoute в обоих режимах, однако разница в 20-70 запросов в секунду на ядро для многих ситуаций значит меньше, чем то, что шлюз умеет и под какую задачу он был разработан.
|
Задача |
Что выбрать |
Почему |
|
Компании необходимо отслеживать, сколько тратит на языковые модели каждое подразделение |
LiteLLM |
расходы по каждому ключу LiteLLM сам записывает в Postgres, а обычных запросов шлюз пропускает больше, чем OmniRoute |
|
Требуется много коротких запросов без потоковой выдачи, например классификация или извлечение данных |
LiteLLM с --num_workers по числу ядер |
130 запросов в секунду на двух ядрах |
|
Агент для программирования с длинными потоковыми ответами на сервере с одним ядром под шлюз |
OmniRoute |
в нашем тесте на одном ядре OmniRoute пропускал больше потоковых запросов, 25 против 20 у LiteLLM. |
|
Бесплатные тарифы и подписки разных поставщиков |
OmniRoute |
шлюз создавался именно под такую работу |
|
Свой vLLM, Ollama или платный API за OmniRoute |
OmniRoute с RATE_LIMIT_AUTO_ENABLE=false |
иначе около одного запроса в секунду и ошибки 429 и 503 под нагрузкой |
У LiteLLM после установки первым делом стоит проверить количество рабочих процессов, поскольку из коробки шлюз занимает одно ядро, сколько бы их ни выделили контейнеру. Также полезно помнить о нагрузке на Postgres. У OmniRoute важнее решить судьбу защиты от лимитов. Для собственной модели ее лучше выключить.
Закажите сервер с уже установленным LiteLLM или OmniRoute и подключите свои модели сразу после запуска.