

 Помощь
 Документация

 Вход


Когда что-то меняется постепенно, шаг за шагом, перемен обычно не замечаешь, а спустя пару лет уже и не можешь представить, как раньше обходился без результата этих перемен. Так вышло и с интернетом.
В сериале «Компьютерщики» дано отличное описание работы в сети Интернет на раннем этапе его развития. Один из героев рассказывает, как ему приходилось ждать целую ночь, чтобы посмотреть одну фотографию. Сейчас такую картину представить сложно, несмотря на все сопутствующие процессы последних лет. Интернет пронизывает повседневный быт, это и место работы, и средство развлечения, и магазин, и энциклопедия.
Такие перемены стали результатом труда очень большого количества ученых, инженеров и технических специалистов, и заметная часть этого труда вложена в объектное хранилище Amazon S3, чей интерфейс 2006 года сегодня реализуют сторонние хранилища по всему миру, включая российские. Статей про S3 множество, однако к двадцатилетию сервиса AWS и ее инженеры опубликовали немало новых подробностей, и собрать эти подробности в одном месте полезно для истории ИТ.
Масштабируемое хранилище для файлов, резервных копий и архивов с API, совместимым с Amazon S3.
Хранение файлов до 2006 года
До появления Amazon S3 файлы сайта, как правило, лежали на дисках того же сервера, на котором работал сам сайт, и пока фотографий и архивов было немного, места на дисках хватало. Когда диск заполнялся, компания покупала еще один сервер или отдельное сетевое хранилище, причем покупала с запасом на год или два вперед, поскольку доставка и установка нового оборудования занимали недели.
Размер запаса оценивали приблизительно, поэтому у сайта, который внезапно становился популярным, свободное место заканчивалось раньше, чем приезжали новые диски, и администраторам приходилось срочно удалять старые файлы или переносить часть файлов на соседние серверы. За исправностью дисков и за резервными копиями следили те же администраторы, а в небольших командах эта работа обычно доставалась разработчикам. С 2006 года файлы можно отправлять в хранилище Amazon по протоколу HTTP и платить по факту использования, ничего не покупая заранее.
Что стало с S3 за двадцать лет
14 марта 2026 года S3 исполнилось двадцать лет, и к юбилею AWS опубликовала ретроспективу, по которой видно, насколько скромным сервис был на старте. В 2006 году все хранилище помещалось в пятнадцати стойках, распределенных по трем центрам обработки данных. Четыреста узлов хранения давали в сумме примерно один петабайт емкости, а общая пропускная способность составляла 15 гигабит в секунду. Размер одного объекта ограничивался 5 ГБ, хранение одного ГБ стоило 15 центов в месяц, и рассчитывали систему на десятки миллиардов объектов.
Сейчас в S3 лежит больше 500 триллионов объектов общим объемом в сотни эксабайт, и сервис обслуживает больше 200 миллионов запросов в секунду в 123 зонах доступности 39 регионов. Предельный размер объекта в декабре 2025 года подняли до 50 ТБ, то есть увеличили в десять тысяч раз по сравнению с 2006 годом, а ГБ стандартного хранения стоит чуть больше двух центов, примерно на 85 процентов дешевле, чем на старте проекта.
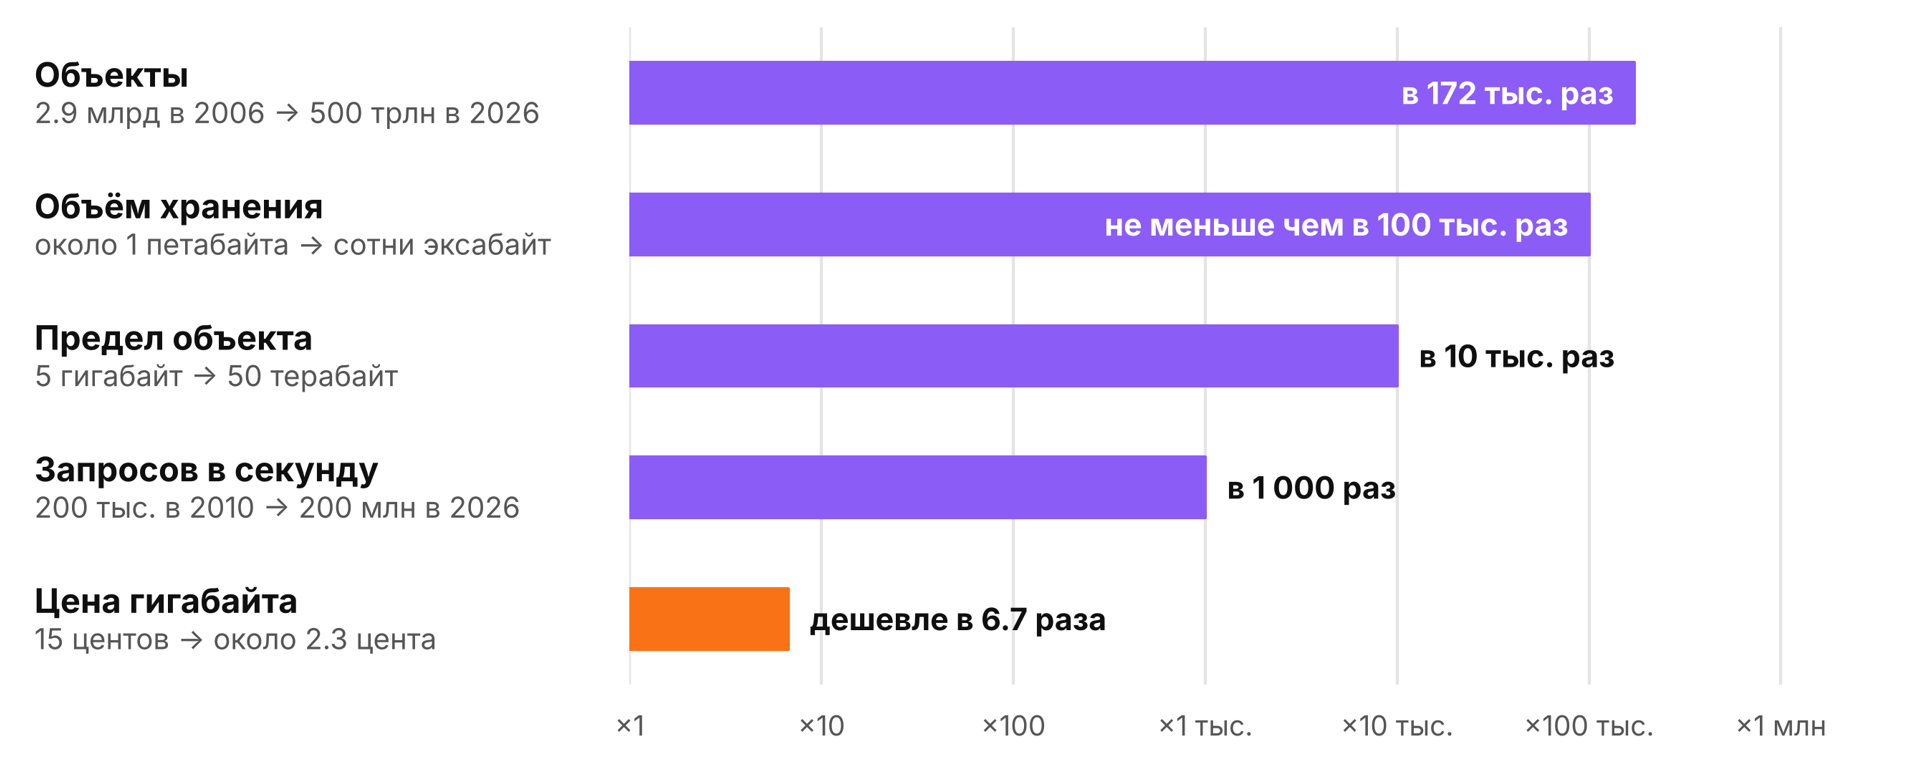
Основные показатели S3 в 2006 и в 2026 году по данным блога AWS и юбилейной ретроспективы.
Смелее всего в ретроспективе звучит утверждение, что код, написанный для S3 в 2006 году, и сегодня работает без изменений, хотя за это время сменилось несколько поколений дисков и систем хранения, а обработку запросов внутри сервиса переписали целиком. С этим утверждением можно согласиться почти полностью, поскольку самый заметный случай, когда совместимость оказалась под угрозой, пришелся на 2019 год.
Тогда AWS объявила, что откажется от одного из двух способов адресации пакетов, а через полтора года отложила отказ и новой даты не назвала. Интерфейс S3 сегодня реализуют многие сторонние хранилища. С наследием S3 поэтому имеют дело и те, кто ни разу не открывал консоль AWS, ведь ограничения и особенности протокола достаются им вместе с любым совместимым хранилищем.
С чего начинался S3 в Amazon
Джефф Барр носит в AWS титул главного евангелиста. Тут стоит сделать небольшое пояснение, так как эта должность не относится к религиозной проповеди, а восходит к истории маркетинга Macintosh. Так в американских технологических компаниях называют человека, который рассказывает разработчикам о продуктах. Барр занимается этим с 2003 года, причем двадцать лет вел официальный блог AWS.
В 2019 году Барр рассказал о том, что исходное задание Джеффа Безоса на S3 было очень коротким и состояло в том, чтобы сделать «malloc для интернета», то есть аналог функции выделения памяти из языка C, только в масштабе сети. Других источников с этой формулировкой найти не удалось, и в юбилейных материалах AWS она не повторяется.
Приходится опираться на воспоминание одного участника, пусть и очень осведомленного. Зато с первой версией S3 сравнение сходится хорошо, поскольку функция malloc выделяет память и возвращает указатель на нее, ничего не зная о том, что программа туда положит, а S3 поначалу почти так же обходился с объ.ектами и строил работу с ними вокруг двух операций, PUT для записи и GET для чтения.
Разработка, по словам Май-Лан Томсен Буковец, которая сейчас отвечает в AWS за направление данных и аналитики, а в команде S3 работает с 2013 года, по-настоящему началась в 2005 году. Сервис вышел 14 марта 2006 года первым из крупных сервисов AWS. Вычислительный сервис EC2 появился в бета-версии только в августе того же года, а пост Джеффа Барра о запуске, как вспоминают в юбилейной ретроспективе, обошелся без примеров кода и демонстраций.
Воспоминания участников запуска позволяют опровергнуть популярную байку, будто Amazon просто начала сдавать в аренду серверы, простаивающие между праздничными распродажами. Вернер Фогельс, технический директор Amazon, еще в 2011 году написал, что эта история является мифом. По его словам, AWS с самого начала считали самостоятельным бизнесом, который со временем может сравняться по размеру с розничной торговлей Amazon, а свободных мощностей Amazon.com новому бизнесу хватило бы всего на два месяца после запуска.
Чем объектное хранилище S3 отличается от файловой системы
Почти всё, что появилось в S3 позже, надстроено поверх двух первых операций. Объект в S3 представляет собой последовательность байтов с метаданными, которая хранится в бакете и доступна по ключу, и никакой другой структуры у хранилища нет. В бакетах общего назначения каталогов тоже нет. Косая черта в ключе `logs/2026/11/05.gz` остается обычным символом, а «папки», которые показывает консоль, получаются из запроса LIST с префиксом и разделителем.
Из-за такой модели объект в бакете общего назначения нельзя изменить частично, как обычный файл, и при любой правке его перезаписывают целиком. Переименовать объект одним запросом в бакете общего назначения тоже нельзя. Сначала объект копируют под новым ключом, затем удаляют старый объект, так что "перенос каталога" с миллионом файлов на деле означает миллион запросов на копирование и миллион запросов на удаление. Запросы на удаление в S3 бесплатны, зато каждое копирование оплачивается как отдельный запрос. Исключением остаются бакеты-каталоги класса S3 Express One Zone, где с июня 2025 года объект переименовывается одним запросом RenameObject без перемещения данных.
Буква S в названии означает Simple, хотя простым сервис выглядит только со стороны клиента. Энди Уорфилд, вице-президент и заслуженный инженер S3, описывает внутреннее устройство сервиса как сотни микросервисов, из которых складываются четыре крупные части, а именно парк входных серверов с интерфейсом REST, служба пространства имен, парк хранения на жестких дисках и группа серверов для фоновых задач вроде репликации. У каждой крупной части есть свой руководитель и свои команды, причем взаимодействие между командами оформлено на уровне программного интерфейса, то есть так же, как взаимодействие между сервисами.
Развитие S3 2006-2026
Первые годы AWS публиковала счетчик объектов почти поквартально, и по постам Джеффа Барра в официальном блоге рост виден очень наглядно. К концу 2006 года в S3 лежало 2.9 миллиарда объектов, к концу 2010 года уже 262 миллиарда при пиковой нагрузке больше 200 тысяч запросов в секунду. До первого триллиона сервис шел шесть лет и добрался до него в июне 2012 года, а второй триллион набрал меньше чем за год, к апрелю 2013-го. В 2022 году объектов стало больше 200 триллионов, а средняя нагрузка перевалила за 100 миллионов запросов в секунду. Если сравнить конец 2006 года с весной 2026-го, число объектов выросло примерно в сто семьдесят тысяч раз, а пиковая нагрузка 2010 года и нынешняя, больше 200 миллионов запросов в секунду, различаются примерно в тысячу раз.
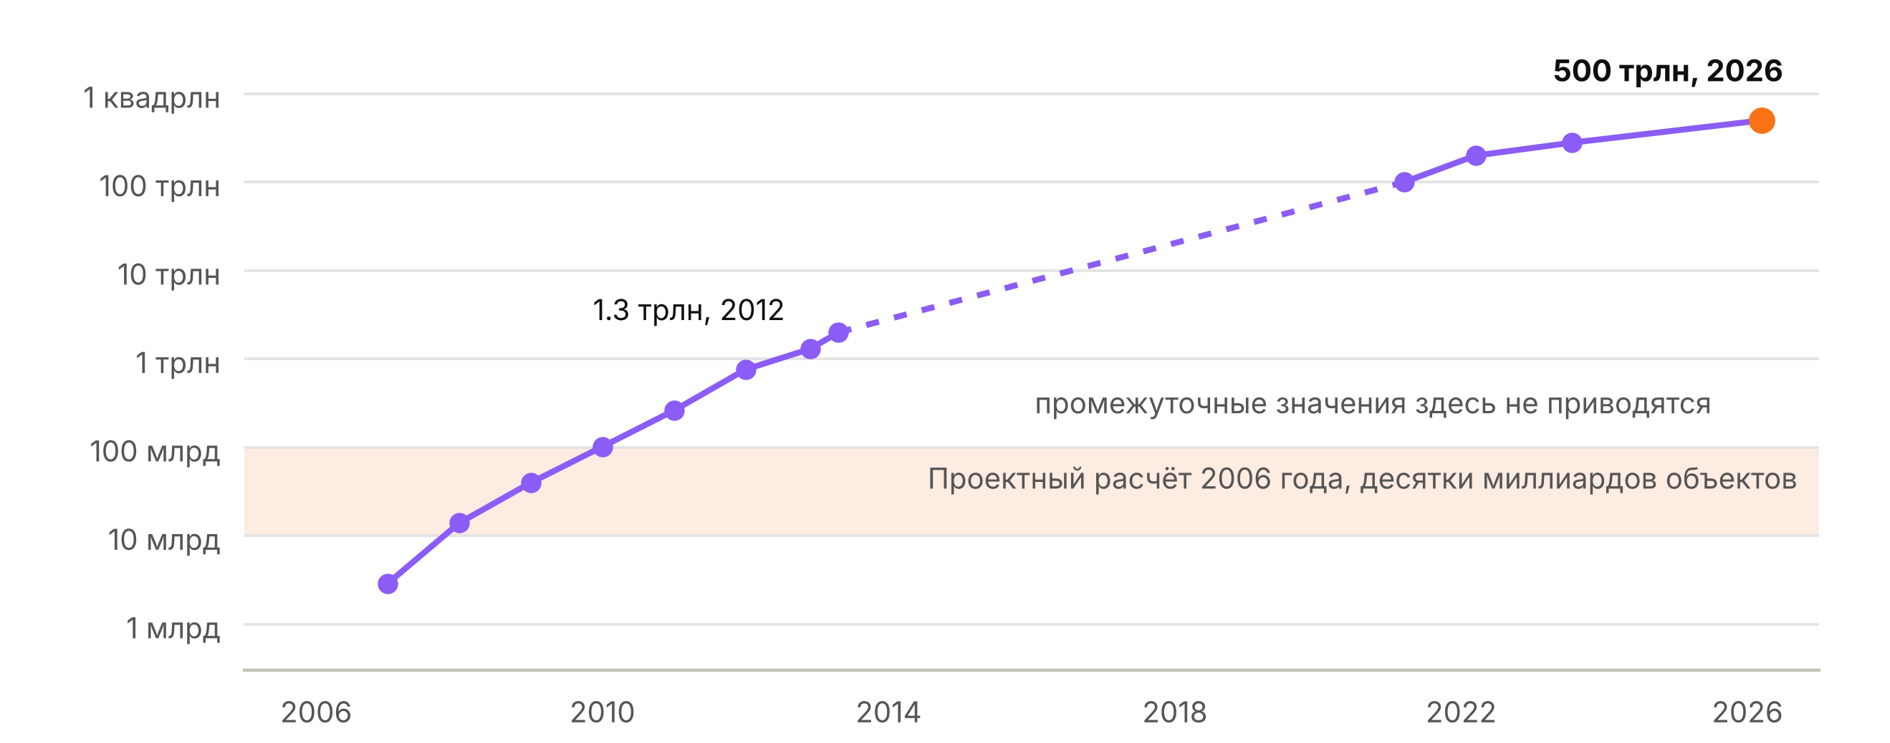
AWS News Blog (2006–2010, 2011, 2012, 2013, 2022, 2023), About Amazon и юбилейная ретроспектива AWS.
До июля 2018 года документация советовала добавлять в начало ключа случайный хеш, чтобы запросы распределялись по разным разделам индекса. Вместе с повышением предельной частоты запросов AWS эту рекомендацию отменила, однако в старых проектах ключи с хешем в начале встречаются до сих пор.
|
Дата |
Изменение |
Значение |
|
12 марта 2026 |
Пространства имен бакетов на уровне аккаунта |
Имя бакета можно закрепить за своим аккаунтом и регионом, и чужой аккаунт его уже не займет |
|
Декабрь 2025 |
Объект до 50 терабайт |
Предел вырос в десять тысяч раз по сравнению с 5 ГБ 2006 года |
|
2025 |
S3 Vectors |
Хранилище векторов для семантического поиска прямо в S3 |
|
Декабрь 2024 |
S3 Tables |
Управляемые таблицы Apache Iceberg с автоматическим обслуживанием |
|
20 августа 2024 |
Условная запись |
Заголовок `If-None-Match` не дает перезаписать уже существующий объект |
|
С 13 мая по 19 августа 2024 |
Бесплатные отказы в доступе |
Владелец бакета перестал платить за чужие запросы с ответом 403 |
|
28 ноября 2023 |
S3 Express One Zone |
Бакеты-каталоги в одной зоне доступности с задержкой в единицы миллисекунд |
|
1 декабря 2020 |
Строгая согласованность чтения после записи |
Чтение сразу после записи возвращает новую версию объекта, без доплаты и для всех бакетов |
|
23 сентября 2020 |
Отказ от path-style отложен |
Адресация через путь продолжает работать, новой даты AWS не назвала |
|
Весна 2019 |
Объявлен отказ от адресации через путь |
Сначала для всех бакетов, через неделю только для новых |
|
17 июля 2018 |
Не меньше 3500 запросов на запись и 5500 на чтение в секунду на префикс |
Отпала необходимость перемешивать ключи ради скорости |
|
28 февраля 2017 |
Сбой в US-EAST-1 |
После сбоя индекс разбили на ячейки поменьше |
|
14 марта 2006 |
Запуск S3 |
Две операции, 5 ГБ на объект, 15 центов за гигабайт |
|
2005 |
Начало разработки |
По словам Май-Лан Томсен Буковец, тогда работа над S3 началась по-настоящему |
Откуда взялась строгая согласованность
До декабря 2020 года сервис не гарантировал, что чтение сразу после перезаписи вернет новую версию объекта, а запрос LIST покажет только что записанный ключ. Вернер Фогельс в статье 2021 года объясняет такое поведение устройством подсистемы метаданных. Перед ней стоит кэш, рассчитанный на то, чтобы запросы выполнялись даже при сбое одной из его частей. Из-за этого запись изредка проходила через одну часть кэша, а чтение обслуживала другая часть, до которой новая версия еще не дошла. Фогельс называет такое поведение кэша главным источником итоговой согласованности S3.
Пока строгой согласованности в S3 не было, клиентам приходилось добиваться ее собственными средствами. Например, Netflix выложила в открытый доступ s3mper, в котором рядом с S3 стояла DynamoDB в роли согласованного хранилища, позволяющего поймать редкий случай устаревшего ответа, а в экосистеме Hadoop похожую задачу решал S3Guard. Для озер данных, которые с середины 2010-х годов массово строили поверх S3, вопрос был вполне практическим, поскольку задание, не увидевшее часть только что записанных файлов, без всяких ошибок считало неверный результат.
Проще всего было бы пускать запросы мимо кэша прямо на уровень хранения, и команда рассматривала такой вариант одним из первых, однако отвергла его, поскольку без кэша сервис работал бы медленнее. Решение построили на логике репликации, которая уже была на уровне хранения метаданных и позволяла установить порядок операций над каждым объектом.
К логике репликации добавили новый компонент, который Фогельс называет «свидетелем». Свидетель получает уведомление при каждом изменении объекта, и при чтении кэш сначала спрашивает у свидетеля, не изменился ли объект, а если изменился, берет свежие сведения с уровня хранения.
Май-Лан Томсен Буковец называет основой решения «реплицированный журнал», то есть цепочку узлов, через которую каждая запись проходит по очереди и получает порядковый номер. Судя по описанию, речь идет о той же логике репликации, хотя прямо Томсен Буковец этого не говорит. Строили журнал, по ее словам, долго, и она называет его «секретным соусом S3».
Строгая согласованность потребовала дополнительного железа, и, по словам Томсен Буковец, в команде спорили, перекладывать ли эти затраты на клиентов, но в итоге сознательно решили этого не делать. В декабре 2020 года строгая согласованность заработала сразу для всех бакетов, без отдельного класса хранения и без доплаты.
Готовую реализацию при этом пришлось еще и проверять, причем, как пишет Фогельс, методы верификации потребовали больше работы, чем сам код, поскольку команде нужна была система «доказуемо корректная, а не просто вероятно корректная». Проверка продолжается и сейчас, и в юбилейной ретроспективе сказано, что при каждом изменении кода индексной подсистемы автоматические доказательства подтверждают, что согласованность не нарушена.
Транзакций S3 не дает и в наши дни. Если два клиента одновременно пишут объект с одним и тем же ключом, останется та запись, которую S3 посчитает последней, при этом успешный ответ получат оба клиента, и о потере данных ни один из них не узнает. Защиту от такой ситуации AWS добавила только в августе 2024 года в виде условной записи с заголовком If-None-Match: *. С таким заголовком попытка создать объект с уже занятым ключом получает ответ 412 Precondition Failed. В ноябре 2024 года появилась и запись с заголовком If-Match. Она проходит только в том случае, если объект не изменился с момента чтения. Конфигурация самих бакетов, судя по документации о модели согласованности, остается согласованной лишь в конечном счете, поэтому только что удаленный бакет какое-то время может показываться в списке бакетов.
Как S3 устроен внутри
Все 500 триллионов объектов в конечном счете записаны на обычные жесткие диски, и архитектуру S3 проще всего понять, если знать, насколько неравномерно эти диски развивались.
По подсчетам Уорфилда, со времен первого серийного накопителя IBM RAMAC 1956 года емкость дисков выросла в 7.2 миллиона раз, а время позиционирования головки сократилось всего в 150 раз, поскольку механика ускоряется гораздо медленнее, чем растет плотность записи. Современный диск при случайном доступе выдает около 120 операций ввода-вывода в секунду, и от емкости это число не зависит.
В 2023 году, когда Уорфилд писал свой текст, самые крупные диски вмещали 26 ТБ, а производители обещали дойти до 200 ТБ, и тогда при равномерном распределении нагрузки на каждые 2 ТБ данных придется примерно одна операция в секунду. Места на дисках хватает с запасом, зато обращений в секунду на хранимый терабайт с каждым поколением дисков становится меньше. Этим разрывом объясняется почти всё в устройстве S3.
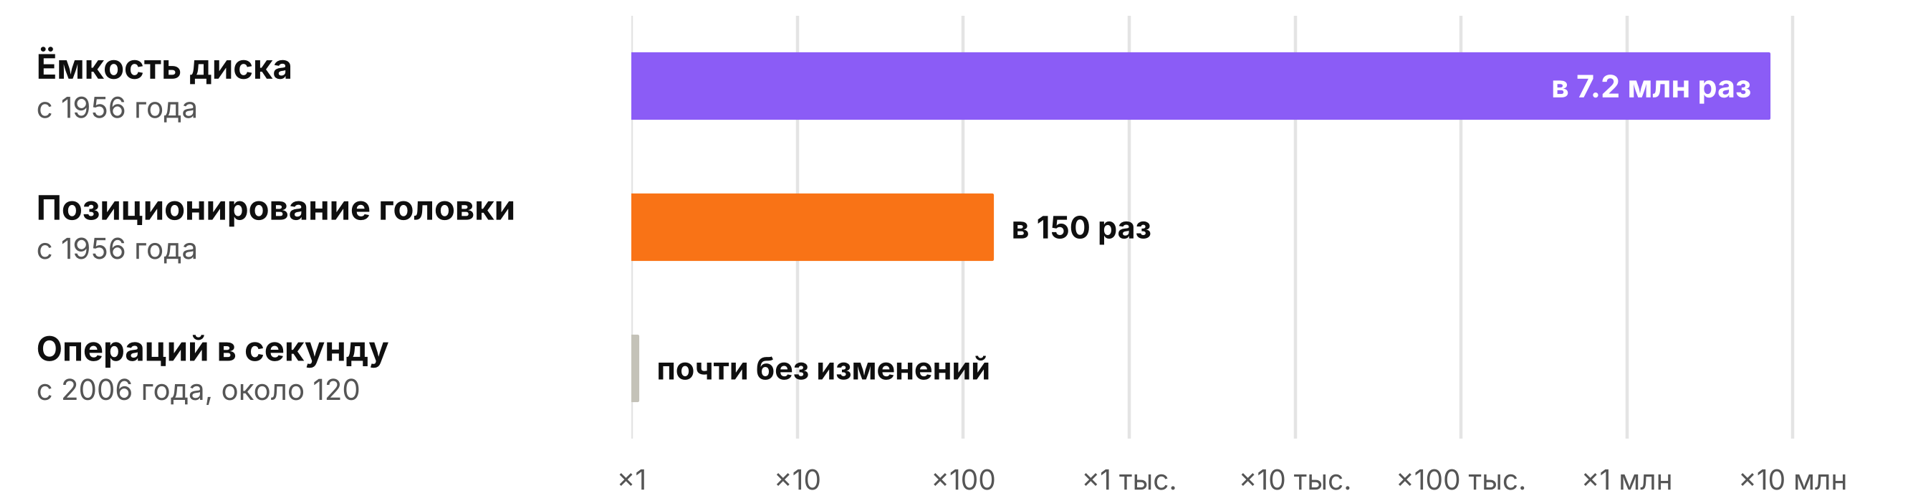
Рост емкости жестких дисков и скорости позиционирования головки с 1956 года по подсчетам Энди Уорфилда
В AWS распределение запросов по дискам называют управлением «нагревом», а нагрев диска измеряют числом запросов, которые приходят на него одновременно. Стоит нескольким дискам перегрузиться, как запросы к ним выстраиваются в очередь, задержка передается слоям, которые работают поверх дисков, в том числе поиску метаданных и избыточному кодированию, и вскоре медленнее отвечает уже весь сервис. Справиться с нагревом помогает сам размер S3.
Отдельный клиент нагружает хранилище неровно, поскольку подолгу почти не обращается к нему, а потом присылает сразу множество запросов, однако когда таких клиентов миллионы, всплески одних приходятся на затишье у других, и общий поток выходит настолько ровным, что ни один клиент уже не способен заметно его изменить.
Пользоваться этим сглаживанием помогает избыточное кодирование, которое нужно прежде всего для сохранности данных. Объект разбивают кодом Рида-Соломона на k частей с данными и m частей с контрольной информацией, и для чтения хватает любых k частей из k+m, так что запрос можно увести от занятого диска. Разные объекты одного бакета сознательно раскладывают по разным наборам дисков.
По словам Уорфилда, у десятков тысяч клиентов бакеты распределены по миллионам дисков, и всплеск от тысяч параллельных функций Lambda, анализирующих геномы, могут обслуживать сразу больше миллиона накопителей. AWS в ретроспективе 2026 года пишет о том же и объясняет, что с ростом S3 нагрузки отдельных клиентов все слабее влияют друг на друга, отчего надежность растет для всех.
Помимо дисков, перегружаться может и индекс, через который проходит больше запросов, чем через саму систему хранения, ведь запросы HEAD и LIST до данных вообще не доходят. Самый известный сбой S3 тоже связан с индексом. 28 февраля 2017 года в регионе Северная Вирджиния инженер ошибся в параметре команды и отключил больше серверов, чем собирался, из-за чего индекс пришлось перезапускать, и восстанавливался он дольше, чем ожидали в AWS. Поэтому, как сказано в разборе инцидента, к разбиению индекса на ячейки меньшего размера, которое планировали начать позже в том же году, приступили немедленно.
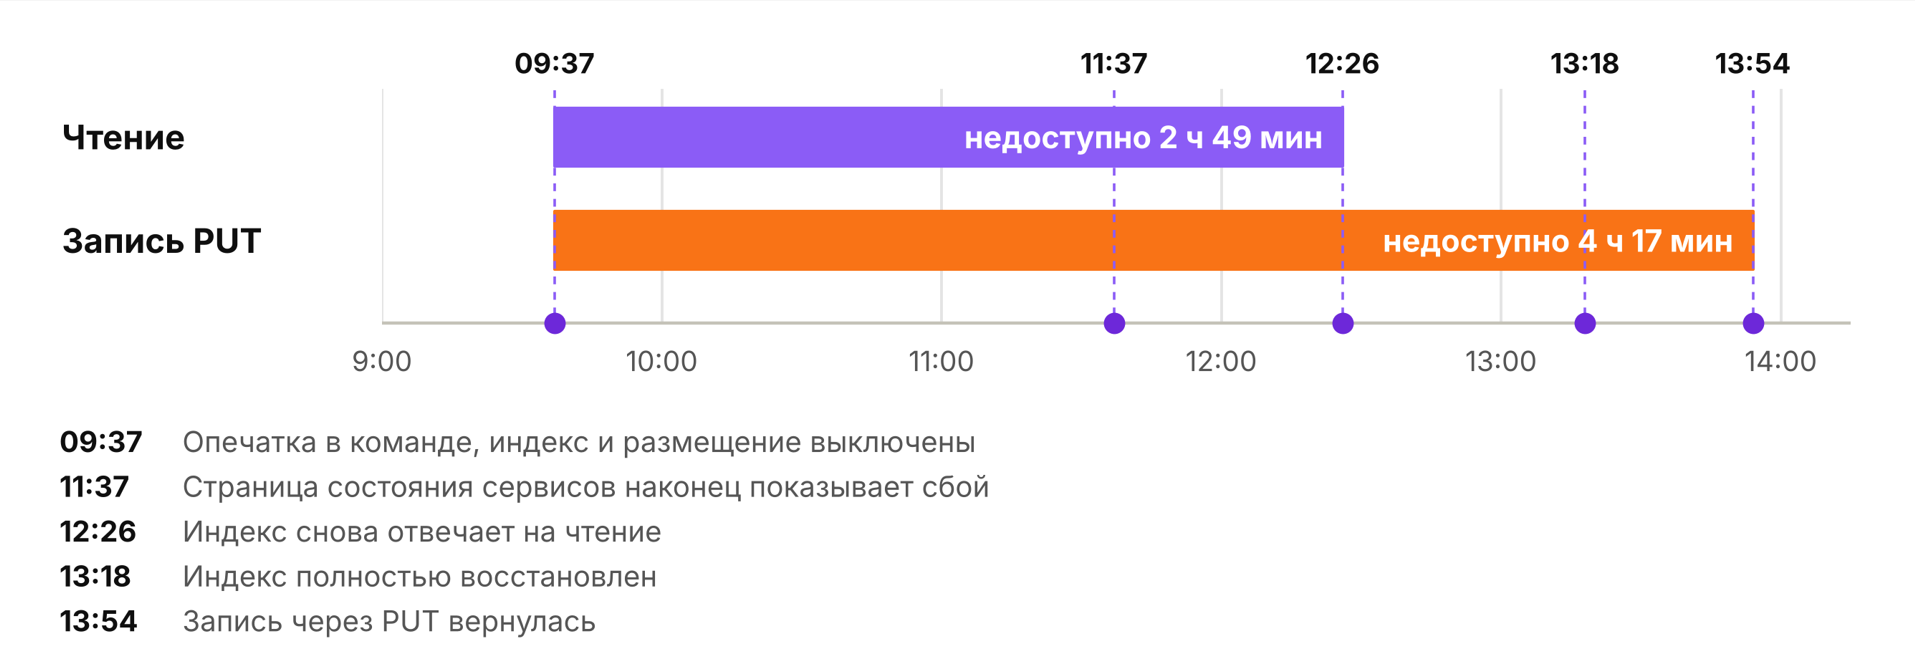
Ход сбоя 28 февраля 2017 года в регионе US-EAST-1 по разбору инцидента, который опубликовала AWS. Время тихоокеанское.
Под индексом и кодированием находится слой, который отвечает за данные на конкретном диске, и этот слой переписали с нуля на Rust, а новая реализация получила название ShardStore. Рядом с рабочим кодом команда держит упрощенную исполняемую модель того же слоя, тоже написанную на Rust и занимающую около одного процента от объема настоящей реализации. При каждом изменении кода автоматические тесты на основе свойств проверяют, что реализация ведет себя так же, как модель, а сама методика описана здесь. В юбилейной ретроспективе сказано, что за восемь лет на Rust переписали также компонент перемещения данных, и работа над другими участками, от которых зависит скорость обработки запроса, продолжается.
Целостность данных при этом проверяют постоянно, для чего специальные сервисы-ревизоры просматривают каждый байт на всех дисках и запускают восстановление, как только замечают признаки повреждения. AWS поясняет, что одиннадцать девяток сохранности данных служат проектной целью, под которую рассчитаны степень избыточности данных и запас мощностей для их восстановления. Томсен Буковец добавляет, что благодаря ревизорам компания может назвать и фактическую сохранность данных за неделю, месяц или год.
Кроме ревизоров, сохранность данных защищает защищает и организационная процедура, а именно отдельный разбор, который проходит любое изменение, способное сказаться на сохранности данных. Построен разбор по образцу модели угроз из информационной безопасности, то есть автор изменения перечисляет все возможные отказы и описывает, какая защита на каждый случай уже есть. Предпочтение отдают грубым и широким ограничителям, которые закрывают сразу целый класс рисков.
Старые бакеты и чужие запросы
Самые известные утечки из S3 случались через бакеты, по ошибке открытые всему интернету, и сам сервис на протяжении долгого времени никак не мешал совершать критические для безопасности ошибки, например, случайно открыть бакет. Бакеты всегда создавались закрытыми, однако открыть их одной галочкой или списком ACL было слишком просто, поэтому в 2018 году AWS добавила блокировку публичного доступа, в 2021 году появилась возможность отключить ACL, а с апреля 2023 года оба этих параметра включены по умолчанию для каждого нового бакета, как бы его ни создавали. К бакетам, созданным раньше, это изменение не применялось, и в старых аккаунтах они живут с прежними настройками до сих пор.
Весной 2024 года разработчик Мацей Почверц завел в регионе eu-west-1 пустой бакет для пробного проекта и через два дня обнаружил в счете больше 1300 долларов за одни сутки. Почти 100 миллионов запросов PUT прислали чужие установки популярной программы с открытым кодом, в настройках которой по умолчанию стояло имя бакета для резервных копий, и это имя совпало с именем бакета Почверца. Хранилище отклоняло такие запросы с ошибкой доступа, однако отклоненные запросы тогда тоже оплачивал владелец бакета. Защититься от подобного совпадения было нечем, поскольку имена бакетов общие для всех клиентов AWS и бакет с именем из чужой программы мог создать кто угодно.
После огласки AWS перестала выставлять владельцу счет за ответы 403 на запросы, пришедшие извне его аккаунта или организации, и это изменение вводили с мая по август 2024 года. На запросы из аккаунтов своей же организации послабление не распространяется, и за отказы в доступе по таким запросам владелец бакета платит, как и раньше. Защититься от такого захвата имени стало возможно только в марте 2026 года, когда в S3 появились пространства имен на уровне аккаунта с именами вида префикс-идентификатор_аккаунта-регион-an. Существующий бакет в новое пространство имен переименовать нельзя, поэтому бакет приходится создавать заново и переносить в него данные.
Ошибки с лимитами запросов и с привязкой к одному региону встречаются реже, но у них чаще тяжелее последствия. На каждый префикс S3 выдерживает не меньше 3500 запросов на запись и 5500 запросов на чтение в секунду, однако при резком росте нагрузки какое-то время отвечает ошибкой 503 Slow Down, пока не разделит перегруженный участок индекса. Зависимость от одного региона опасна еще и тем, что вместе с приложением отказывают средства оповещения. Во время аварии 2017 года сама AWS до 11:37 не могла обновить страницу состояния сервисов, поскольку консоль этой страницы зависела от S3.
Как API S3 стал общим языком объектных хранилищ
В XML-ответах S3 до сих пор стоит пространство имен http://s3.amazonaws.com/doc/2006-03-01/ с датой первой версии API, и ровно та же строка встречается в документации хранилищ, которые к Amazon никакого отношения не имеют. AWS пишет, что интерфейс S3 стал образцом для отрасли и что совместимые с ним системы выпускают многие производители. Среди таких систем есть и проекты с открытым кодом вроде Ceph и MinIO, и хранилища облачных платформ.
Разработчику совместимость выгодна тем, что AWS CLI, привычные SDK и библиотеки, которые умеют писать в S3, начинают работать с другим хранилищем, стоит заменить адрес точки подключения. Вместе с интерфейсом совместимые хранилища наследуют и решения 2006 года, то есть плоское пространство ключей без каталогов, отсутствие переименования и перезапись объекта целиком, даже если внутри такое хранилище устроено совсем иначе, чем S3.
Чего такая роль стоит самой AWS, видно по тому, как компания пыталась отказаться от одного из двух способов адресации бакетов. Имя бакета можно указать либо в пути запроса, как в https://s3.amazonaws.com/bucket/key, либо в имени хоста, как в https://bucket.s3.amazonaws.com/key.
Весной 2019 года AWS объявила, что 30 сентября 2020 года полностью прекратит поддержку первого способа, то есть адресации через путь (path-style). Отзывы клиентов заставили компанию пересмотреть план, и уже через неделю Джефф Барр признал, что объявление вышло «довольно тихим, на самом деле даже слишком тихим». Тогда же он сообщил, что адресация через путь сохранится для всех бакетов, созданных не позже 30 сентября 2020 года.
Главным доводом в пользу отказа AWS называла то, что адресация через имя хоста сужает круг клиентов, которых затрагивает неполадка, и внутри компании этот круг называют радиусом поражения. Помешали плану бакеты с точкой в имени. Такие имена допустимы и широко используются для размещения сайтов, однако при адресации через имя хоста у бакетов с точкой возникают известные проблемы с сертификатами TLS. В обновлении от 23 сентября 2020 года AWS сообщила, что откладывает отказ от адресации через путь, чтобы у клиентов было время на переход, и новой даты с тех пор не называла.
Совместимые хранилища, поднятые на собственных серверах без отдельного домена под каждый бакет, обычно опираются как раз на path-style, а SDK сами переключаются на этот способ, когда в адресе точки подключения нет доменного имени. Заявление компании о том, что “код 2006 года работает без изменений” держится, таким образом, еще и на том, что AWS так и не довела отказ от адресации через путь до конца.
Среди российских облачных платформ совместимость особенно заметна на примере Yandex Object Storage, у которого справочник API так и называется, REST, совместимый с Amazon S3. Полной совместимости при этом не бывает. Например, в Yandex Cloud метки ресурсов называются label, однако в API и командах AWS CLI используется амазоновский термин тег (tag).
Заголовок X-Amz-Grant-Write в методе bucketPutAcl принимается только вместе с X-Amz-Grant-Read, иначе хранилище отвечает кодом 501 Not Implemented, а запросы на языке S3 Select включаются только через техническую поддержку. Похожие ограничения есть и у других совместимых хранилищ, поэтому перечень поддерживаемых методов у выбранного поставщика всегда следует изучить до переезда.
У нашего хранилища совместимость тоже неполная. Версионирование объектов поддерживается, однако включить его запросом к API или в панели управления пока нельзя, поэтому приходится писать в техническую поддержку. Шифрования данных на стороне хранилища сейчас нет, а в одном хранилище можно создать не больше ста бакетов. Адрес объекта строится через путь.
В январе 2025 года совместимость со сторонними хранилищами нарушила сама AWS, когда изменила поведение своих клиентских библиотек. Официальные SDK и AWS CLI в версиях, вышедших около 15 января, стали по умолчанию считать контрольную сумму CRC32 или CRC64NVME для каждой загрузки и проверять ее при скачивании.
Для самого S3 изменение полезное, однако многие сторонние хранилища новые заголовки не понимали и начали отвечать ошибками на обычные запросы PutObject и UploadPart. Akamai, например, в своей документации перечисляет затронутые версии, начиная с AWS CLI 2.23.0 и boto3 1.36.0, а Outscale отмечает, что в AWS CLI с 2.23.0 по 2.23.4 команда aws s3 cp игнорировала настройку, которая должна была отключать расчет контрольных сумм. В репозитории SDK для JavaScript AWS предупреждает, что может включать новые возможности по умолчанию, не дожидаясь их поддержки в совместимых хранилищах других компаний.
Во что S3 превращается сейчас
В последние три года S3 получает возможности, которые плохо сочетаются со словом Simple в названии сервиса. В ноябре 2023 года появился S3 Express One Zone, отдельный класс хранения с новым типом бакетов, так называемыми бакетами-каталогами. Данные в них лежат в одной выбранной зоне доступности, задержка измеряется единицами миллисекунд, а имя бакета строится по особому формату с идентификатором зоны и суффиксом --x-s3.
Ради скорости в бакетах-каталогах отказались от части привычных функций, и на момент запуска там не было, например, ни версионирования, ни репликации, так что переносить в Express One Zone бакет со всеми его настройками без проверки рискованно. Цены на Express One Zone компания позже снизила, по отдельным статьям на 85 процентов.
Аналитикой поверх данных в облаке AWS задолго до появления S3 Tables занимались другие компании, в том числе Snowflake. В проспекте к размещению акций 2020 года Snowflake пишет, что предлагает свою платформу только в публичных облаках AWS, Azure и GCP, владельцы которых одновременно с ней конкурируют, и что «значительная часть» ее бизнеса работает в облаке AWS. Там же компания признает, что ее затраты и валовая маржа зависят от цен, о которых удается договориться с поставщиками облачных услуг.
В 2024 году AWS занялась этим и сама, когда в S3 появились S3 Tables, то есть управляемые таблицы в формате Apache Iceberg. Сервис сам обслуживает эти таблицы, в частности объединяет мелкие файлы в крупные и удаляет устаревшие снимки. Тогда же в предварительной версии вышла функция S3 Metadata, с которой объекты можно искать по метаданным обычным запросом к таблице, без обхода огромных бакетов запросами LIST. В июле 2025 года она охватила и уже существующие объекты. В декабре 2025 года стало общедоступным S3 Vectors.
S3 Vectors хранит векторные представления для семантического поиска и для генерации ответов с опорой на найденные документы (RAG), и с искусственным интеллектом историю S3 связывает прежде всего эта функция. Векторное представление текста или изображения требует места, и держать сотни миллионов векторов в специализированной базе данных дорого, поэтому AWS предлагает хранить векторы в S3, рядом с исходными документами. Один индекс S3 Vectors вмещает до 2 миллиардов векторов и отвечает на запрос быстрее чем за 100 миллисекунд.
По данным ретроспективы, с июля по декабрь 2025 года пользователи создали больше 250 тысяч индексов, загрузили 40 миллиардов векторов и выполнили около миллиарда запросов. Для сравнения, миллиард запросов за пять месяцев дает в среднем около 75 запросов в секунду, то есть меньше одной миллионной от тех 200 миллионов запросов в секунду, которые обслуживает сам S3, хотя в эти пять месяцев входит и период предварительной версии.
AWS пишет, что S3 должен стать универсальной основой для любых данных, которые хранят один раз и обрабатывают на месте, не перекладывая между специализированными системами. Сбудется ли этот замысел в полной мере, судить сложно, поскольку специализированные векторные базы и табличные хранилища вне S3 продолжают развиваться своим путем.
Вместо заключения
Почти все цифры в этой статье взяты из публикаций AWS, так что относиться к этим данным стоит как к заявлениям заинтересованной стороны. Воспоминания участников тоже не являются безоговорочно надежным источником. Например, Май-Лан Томсен Буковец называет исходным пределом размера объекта 5 ТБ, хотя в 2006 году предел составлял 5 ГБ. Фраза о «malloc для интернета» известна только в пересказе Джеффа Барра. Лимиты, форматы имен и поведение SDK меняются по нескольку раз в год. За рамками статьи остались классы хранения и их цены, архивный Glacier, репликация между регионами и шифрование.
Стандартом интерфейс S3 сделали простота первых двух операций, оплата по факту использования и двадцать лет обратной совместимости, из-за которых сторонним разработчикам оказалось проще повторить чужой API, чем придумывать свой. Объектное хранилище устроено иначе, чем файловая система, и тот, кто обращается с бакетом как с диском, платит за это лишними запросами, а значит деньгами и временем.
Масштабируемое хранилище для файлов, резервных копий и архивов с API, совместимым с Amazon S3.