

 Помощь
 Документация

 Вход


Введение
Языковые модели за пару лет превратились из диковинки и в повседневный рабочий инструмент, и в предмет постоянных споров. Сложно сравнить, какие генеративные модели популярнее, но то, что многие используют именно облачные сервисы, сомнения не вызывает. И пока всё работает штатно, вопрос, где именно работает модель, мало кого волнует. К сожалению, штатно работает далеко не всегда: сервис вдруг становится недоступен из-за региональных ограничений или блокировок, провайдер без предупреждения меняет цены и квоты, а заодно встаёт вопрос о том, куда уходят персональные данные клиентов или сотрудников. Модель на собственном сервере решает эти проблемы, но требует погружения в администрирование как сервера, так и самих движков моделей. Кроме того, её можно настроить под себя, то есть подобрать размер под задачу и бюджет, обучить на собственных данных, зафиксировать версию и быть уверенным, что завтра она ответит почти так же, как сегодня.
Последние версии популярных LLM-моделей уже предустановлены на вашем сервере.
Обзор языковых моделей DeepSeek
Моделей становится всё больше. Текущая статья была запланирована давно, и в плане стояли 7B, 33B и 67B, но теперь они уже устарели. Это первое поколение конца 2023 года, когда вышли DeepSeek LLM на семь и шестьдесят семь миллиардов параметров (обе до сих пор встречаются в сравнительных исследованиях как отдельные базовые модели) и серия DeepSeek Coder для кода, старшая версия которой имела тридцать три миллиарда. С нынешними моделями DeepSeek у этого поколения общего только название, поэтому команда ollama run deepseek-coder из старых инструкций приводит к модели почти трехлетней давности.
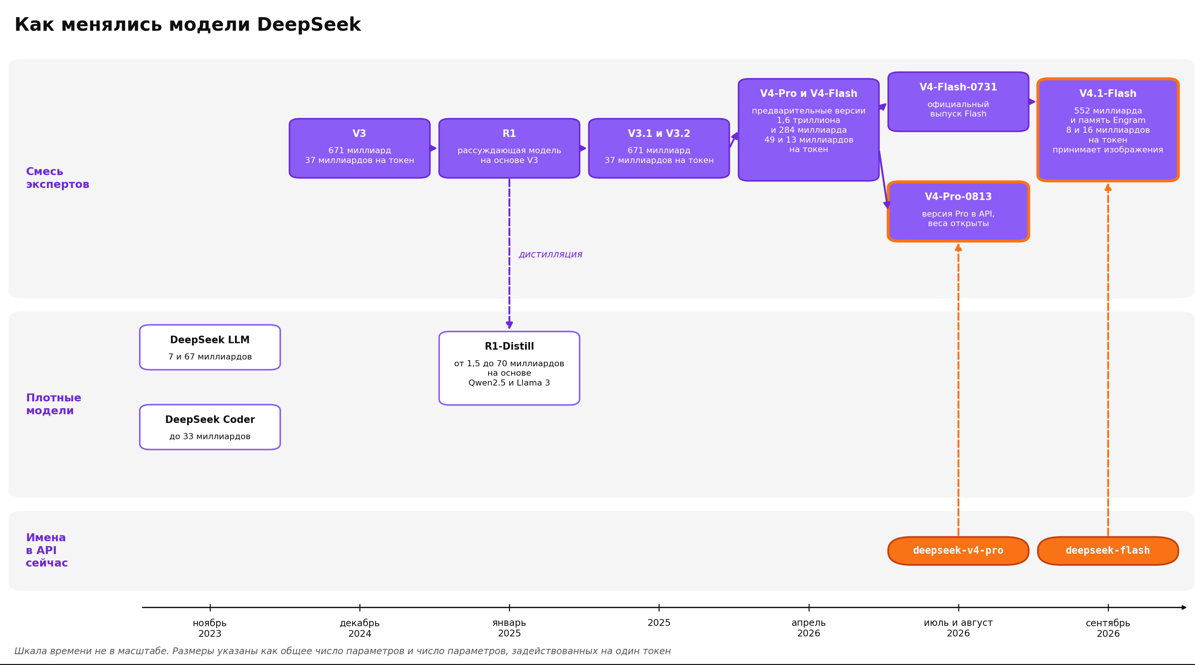
Модели DeepSeek с 2023 по 2026 год. На собственном сервере с одной видеокартой запускаются модели из нижней полосы
Линейка V4 и V4.1
Для нынешних моделей DeepSeek выбрала архитектуру смеси экспертов (MoE), поэтому у каждой модели указано два числа параметров. В каждом слое такой модели вместо одного большого вычислительного блока стоят десятки или сотни небольших блоков («экспертов»), и маршрутизатор для каждого токена выбирает лишь несколько из них. Понять, поместятся ли веса на сервер целиком, можно по общему числу параметров. От числа параметров, задействованных на один токен, зависит объем вычислений и скорость генерации, из-за чего модель на триллион параметров, у которой на токен работает несколько десятков миллиардов, выдает текст примерно с той же скоростью, что и плотная модель на несколько десятков миллиардов.
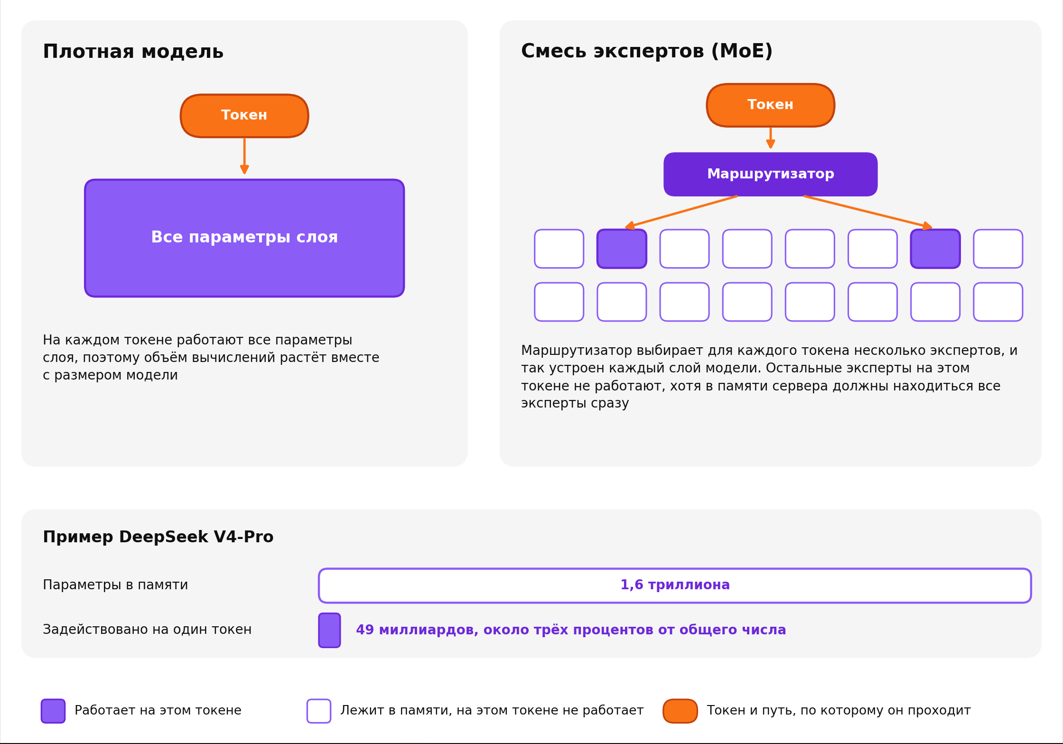
Как токен проходит через слой плотной модели и через слой со смесью экспертов
В апреле 2026 года вышли предварительные версии V4-Pro на 1,6 триллиона параметров, из которых на каждый токен задействовано 49 миллиардов, и V4-Flash на 284 миллиарда параметров с 13 миллиардами на токен, обе с контекстом в миллион токенов. Веса выложены под лицензией MIT, которая, согласно тексту карточки, распространяется и на репозиторий, и на сами веса. Параметры экспертов хранятся в четырехбитном формате FP4, почти все остальные параметры — в FP8. Такую точность разработчики закладывали еще при обучении, поэтому привычной версии весов в шестнадцати битах у рабочих моделей нет.
Летом текущего года вышла обновленная V4-Flash-0731, а в начале сентября DeepSeek выложила V4.1-Flash, название которой может немного сбить с толку. Основа V4.1-Flash выросла до 552 миллиардов параметров, то есть почти вдвое против V4-Flash, модель научилась принимать изображения, а поверх основы добавилась условная память Engram на 196 миллиардов параметров, к которой модель обращается выборочно по токенам. В каждом слое теперь один общий эксперт и 384 эксперта, которых выбирает маршрутизатор, причем на токен включаются шесть из них. Задействованных параметров стало меньше, восемь миллиардов при обработке запроса и шестнадцать при генерации ответа, так что слово Flash в названии говорит скорее о стоимости вычислений на токен, а не о размере весов.
Разработчики V4 отказались от шаблона чата в формате Jinja и вместо него положили в репозиторий папку encoding с кодировщиком на Python, собирающим диалог в строку - он же разбирает ответ модели. Такой подход описан в карточках V4-Flash и V4-Flash-0731. Позже шаблоны в репозиториях все же появились благодаря сотрудникам Hugging Face и сообществу, а запись об отсутствии штатного шаблона в карточках так и осталась. Для боевого применения DeepSeek выпустила библиотеку deepseek-recipe на Rust с привязками для Python, которая занимается только преобразованием запросов и разбором ответов, вычислениями же модели не управляет и движком вывода не является. Запускать V4-Flash через llama.cpp сообщество научилось не сразу, обсуждение поддержки открылось еще в апреле, а рабочие сборки весов появились к версии 0731.
Требования DeepSeek к ресурсам*
|
Модель |
Параметров всего |
Задействовано на токен |
Контекст |
Объем весов (Гб) |
|
V4-Pro |
1,6 триллиона |
49 миллиардов |
миллион токенов |
865 |
|
V4-Pro-0813 |
1,6 триллиона |
49 миллиардов |
миллион токенов |
893 |
|
V4-Flash |
284 миллиарда |
13 миллиардов |
миллион токенов |
160 |
|
V4-Flash-0731 |
284 миллиарда |
13 миллиардов |
миллион токенов |
167 |
|
V4.1-Flash |
552 миллиарда, 196 миллиардов памяти Engram |
8 миллиардов при обработке запроса, 16 при генерации |
миллион токенов |
510 |
|
R1-Distill-Qwen-14B |
14 миллиардов |
14 миллиардов |
128 тысяч токенов |
29.5 в исходной точности, около 9 в четырех битах |
* Объемы получены суммированием файлов в репозиториях Hugging Face через программный интерфейс площадки 23.09.2026 г.
Из представленных данных мы видим, что ни одна модель линейки V4 не помещается ни в двадцать четыре, ни в сорок восемь гигабайт видеопамяти даже при самом агрессивном квантовании.
Gemma 4 (Google)
Линейка моделей Gemma 4 вышла 2 апреля 2026 года под лицензией Apache 2.0, что довольно важно, ведь Gemma 3 распространялась под собственной лицензией Google, и ее веса на Hugging Face до сих пор закрыты формой согласия с условиями использования, тогда как репозитории Gemma 4 открыты. Политика запрещенного использования Gemma написана как часть прежних условий и датирована февралем 2024 года, поэтому при переносе модели в промышленную эксплуатацию юридическую часть стоит поверять тщательно.
Размеры моделей Gemma
|
Модель |
Количество параметров (млрд.) |
Задействовано на токен (млрд.) |
Контекст (тысяч) |
Модальности |
|
E2B |
5.1 |
2.3 |
128 |
текст, изображения, звук |
|
E4B |
8 |
4.5 |
128 |
текст, изображения, звук |
|
12B Unified |
11.95 |
11.95 |
256 |
текст, изображения, звук |
|
26B A4B |
25.2 |
3.8 |
256 |
текст, изображения |
|
31B |
30.7 |
30.7 |
256 |
текст, изображения |
Буква E в названиях младших моделей обозначает полезные параметры, т. к. эти модели используют послойные таблицы эмбеддингов, которые хоть и занимают место, но работают как быстрый справочник, а не как вычисления. Слово Unified у модели 12B указывает на отсутствие отдельных кодировщиков, т. е. она принимает необработанные фрагменты изображения и куски звука прямо во входное пространство. У MoE-варианта 26B A4B в каждом слое сто двадцать восемь экспертов плюс один общий.
Сколько занимает памяти*
|
Модель |
Веса bfloat16, (Гб) |
Веса в четырех битах (Гб) |
Кэш в 8 битах при 32 тысячах токенов, (Гб) |
|
E2B |
4.6 |
0.8 |
0.05 |
|
E4B |
9 |
2.3 |
0.14 |
|
12B |
24 |
7.65 |
0.28 |
|
26B A4B |
52 |
16.2 |
0.28 |
|
31B |
64 |
19.2 |
1.1 |
* Использованы данные из таблицы 3 технического отчета Gemma 4. Сжатие у E2B и E4B мобильное, со смесью двух- и четырехбитных весов, у остальных моделей формат Q4_0.
У Gemma 4 12B кэш на тридцать две тысячи токенов контекста занимает 280 Мб или около одного процента от объема весов в исходной точности. Компактность обеспечивается за счет архитектуры. На один глобальный слой внимания у моделей, начиная с 12B, приходится пять локальных с окном в 1024 токена, на глобальных слоях ключи также используются в роли значений, и вместе с позиционным кодированием p-RoPE эти приемы сокращают глобальный кэш максимум на 37,5 процента.
Наше тестирование на стенде с RTX 4090 это подтвердило эффективность подобного подхода. У Gemma 4 12B занятая видеопамять выросла от окна в четыре тысячи токенов до окна в 256 тысяч всего на 4.2 гигабайта, с 7.9 до 12.1, у Gemma 4 26B A4B на 5.2 гигабайта, с 15.7 до 20.9, и обе модели держали всё окно целиком на карте. Дистилляту DeepSeek на четырнадцать миллиардов параметров, построенному на Qwen2.5, на то же окно по формуле понадобилось бы около 48 гигабайт одного только кэша, вдвое больше всей памяти карты. У Gemma 4 31B кэш заметно тяжелее, 1.1 гигабайта на 32 тысячи токенов, и на 4090 она целиком помещается только до окна в 32 тысячи.
Какие версии Gemma 4 скачивает Ollama*
|
Тег |
Объем (Гб) |
Примечание |
|
gemma4 без тега |
9.6 |
то же, что gemma4:e4b, модель для ноутбуков и телефонов |
|
gemma4:12b-it-qat |
7.2 |
Модель, которую дообучали с встроенной симуляцией 4-битного формата (Quantization-Aware Training) и она дообучена на инструкциях (Instruction Tuning), а значит может работать с tools (чего не умеет базовая gemma4) |
|
gemma4:26b-a4b-it-qat |
16 |
MoE-вариант |
|
gemma4:26b |
19 |
26B A4B в сжатии q4_K_M вместе с небольшой моделью для ускоренной генерации |
|
gemma4:31b-it-qat |
19 |
старшая модель, IT + QAT |
|
gemma4:31b-it-q4_K_M |
20 |
Cжатие после обучения |
* Объемы указаны по странице тегов Ollama. Команда `ollama list` на сервере показывает их примерно на гигабайт меньше, поэтому в таблицах с замерами ниже числа для тех же моделей отличаются.
Команда ollama pull gemma4 без тега выглядит как запрос флагмана, но по факту получаем модель E4B, рассчитанную не на сервер, а на ноутбуки и телефоны. На странице тегов у gemma4:latest и gemma4:e4b один и тот же отпечаток, так что размер модели в команде стоит указывать.
Варианты с пометкой qat Google обучала с учётом будущего квантования: имитация четырёхбитного формата встроена прямо в процесс обучения, поэтому после квантования модель теряет меньше качества. Весят они меньше обычных четырёхбитных: 19 против 20 ГБ у 31B и 16 против 19 у 26B A4B, а на нашем тестовом стенде вариант qat у 31B оказался ещё и на пять процентов быстрее. Тег gemma4:26b ведёт на вариант в сжатии q4_K_M с добавлением спекулятивной генерации: небольшая модель-«черновик» быстро предсказывает несколько токенов вперёд, а основная проверяет их за один проход. Google обещает ускорение до трёх раз; на стенде этот вариант генерировал на 18 процентов быстрее, чем qat без дополнительной модели.
Что важно учитывать при запуске Gemma 4
Google рекомендует для Gemma 4 температуру 1,0, top-p 0,95 и top-k 64, и они прописаны в конфигурации модели по умолчанию. Режим рассуждения включается токеном <|think|> в системном сообщении и Ollama включает его по умолчанию. Для его выключения можно использовать или ключ --think=false в командной строке, или поле "think": false в интерфейсе Ollama, или параметром "reasoning_effort": "none" в интерфейсе, совместимом с OpenAI. При выключенном рассуждении все модели, кроме E2B и E4B, все равно выводят пустой блок размышления. Ollama держит в видеопамяти проектор изображений даже при чисто текстовой работе, и у старшей модели он отнимает у контекста 1.27 гигабайта. Текстовая версия без проектора собирается из тех же файлов и на RTX 4090 помещается целиком с окном в 48 тысяч токенов вместо 32 тысяч, рецепт в разделе про замеры.
Данные для обучения обрезаны январем 2025 года, т.е. спрашивать модель о событиях после этого момента не имеет смысла.
Почему Gemma 4 подходит для сервера с одной картой
В рейтинге Arena Gemma 4 31B набирала 1451 балл против 1456 у DeepSeek V4 Pro на 1,6 триллиона параметров, такие данные Google приводит в техническом отчете. Разница около трети процента укладывается в погрешность оценки, а вот по размеру модели различаются в пятьдесят раз. Gemma 4 26B A4B с ее 1438 баллами стоит рядом с DeepSeek V4 Flash в режиме рассуждения, у которой 1436 при 284 миллиардах параметров. На нашем стенде с одной RTX 4090 обе старшие Gemma поместились на карту, хотя и с разными ограничениями. Gemma 4 26B A4B генерирует около двухсот токенов в секунду и держит все окно в 256 тысяч токенов. Gemma 4 31B выдает около 46 токенов в секунду и помещается целиком только до окна в 32 тысячи, которое сжатием кэша удается расширить до 64 тысяч, а отказом от проектора изображений до 48.
Phi от Microsoft
Для сравнения мы также взяли модель двухлетней давности из 2024 года, а именно Phi от Microsoft. Специфика данной модели заключается в подходе к обучению модели на отобранных и специально подготовленных данных вроде учебников, из-за чего при небольшом размере она показывает результаты, сопоставимые с более крупными моделями. У Phi-4 это 9,8 триллиона токенов обучения на 1920 картах H100 за двадцать один день. У этого подхода есть существенный недостаток, малое количество многоязычных данных, и Microsoft пишет, что модель не рассчитана на языки кроме английского. На нашем стенде при этом обе рассуждающие версии Phi, например, верно решили задачу, сформулированную на русском языке.
Модели семейства Phi-4
|
Название модели |
Количество параметров (миллиардов) |
Контекст (тысяч токенов) |
Особенности |
Лицензия |
|
Phi-4 |
14 |
16 |
базовая модель, ориентирована на английский язык |
MIT |
|
Phi-4-mini-instruct |
3.8 |
128 |
заявлены 23 языка, включая русский |
MIT |
|
Phi-4-reasoning-plus |
14 |
32 |
MIT |
|
|
Phi-4-reasoning-vision-15B |
15 |
16 |
принимает изображения |
MIT |
Еще одна особенность семейства Phi-4 состоит в непривычном распределении длины контекста. У младшей модели на 3,8 миллиарда параметров окно в 128 тысяч токенов, и на нашем стенде Ollama подтвердила его значением 131 072, а у старших моделей на четырнадцать и пятнадцать миллиардов окно всего 16 и 32 тысячи, так что для длинных документов из всего семейства подходит как раз младшая.
Какие версии Phi скачивает Ollama
|
Тег |
Объем (Гб) |
Контекст (тысяч токенов) |
|
phi4-mini |
2.5 |
128 |
|
phi4-mini:3.8b-q8_0 |
4.1 |
128 |
|
phi4-reasoning |
11 |
32 |
|
phi4-reasoning:plus |
11 |
32 |
|
phi4-mini-reasoning |
3.2 |
128 |
Для восьмибитного варианта Phi-4-mini страница тегов показывает окно в четыре тысячи токенов, но на стенде `ollama show` сообщила о 131 072, и модель поднялась с тем же окном по умолчанию в 32 768 токенов, что и остальные, так что четыре тысячи на сайте оказались ошибкой отображения. При весах в 4.1 Гб с таким окном модель заняла в видеопамяти 8,6, то есть у маленьких моделей кэш контекста легко сравнивается по объему с самими весами.
Как запускать Phi
Phi ждет собственный формат диалога с разделителями <|im_start|> и <|im_sep|>. Версию plus Microsoft дообучила еще и с подкреплением, по идее она точнее, но и генерирует в среднем в полтора раза больше токенов, если считать вместе с рассуждением. На нашем стенде на русскоязычной задаче phi4-reasoning написала 1 863 токена и ответила за 24 секунды, а phi4-reasoning:plus написала 2 893 токена, на 55 процентов больше, и ответила за 38 секунд.
Запуск DeepSeek, Gemma, Phi на RTX 4090
На вопрос, что получит человек, арендовавший сервер с одной видеокартой, может ответить только практика, поэтому мы взяли сервер с одной RTX 4090 и прогнали на нем девять моделей из трех семейств, сначала в Ollama, а потом в vLLM. Почти все запросы были на русском языке - от короткого приветствия до технического текста на полторы сотни тысяч токенов. Для сравнения часть тестов повторили на английском, так что заодно получилось посмотреть, как отличается работа с моделями на русском и английском языках.
Стенд и методика
|
Тип оборудования |
Название |
|
Видеокарта |
GeForce RTX 4090, 24 Гб, Ollama видит 23.5 Гб |
|
Процессор |
AMD Ryzen 9 7950X, 16 ядер, 32 потока |
|
Оперативная память |
128 Гб DDR5, четыре модуля по 32 Гб |
|
Диск |
NVMe, 1 Тб |
|
ОС |
Ubuntu 24.04.5 LTS, драйвер 595.91.07, CUDA 13.2 |
|
Движки |
Ollama 0.34.4, vLLM 0.30.0 в Docker 29.1.3 |
Замеры в Ollama проводились с помощью скрипта на Python, который обращается к программному интерфейсу Ollama и параллельно четыре раза в секунду опрашивает nvidia-smi, чтобы поймать пик занятой памяти, а не среднее значение. Скорость генерации сценарий берет из статистики самой Ollama, поэтому время загрузки модели в нее не попадало. Параметры выборки выставлены по рекомендациям разработчиков, то есть температура 1,0 и top-k 64 для Gemma, 0,6 для дистиллята DeepSeek и 0,8 с top-k 50 для рассуждающих версий Phi. Для vLLM понадобился отдельный сценарий, поскольку у него только совместимый с OpenAI интерфейс. Параметры выборки vLLM сам взял из файла настроек модели, и они совпали с теми, что стояли в Ollama.
Модели скачивались из реестра Ollama прямо на сервер, размещенный в России, со скоростью около 115 мегабайт в секунду. Hugging Face, Docker Hub и репозиторий NVIDIA тоже открылись без обходных путей.
Все замеры проводились на карте, размещенной в стойке дата-центра. Отдельным получасовым прогоном старшей Gemma проверили, что под непрерывной нагрузкой карта не сбрасывает частоту, температура за полчаса не поднялась выше 51 градуса, а частота все время держалась на 2790 мегагерцах, так что числа, снятые в начале и в конце дня, сопоставимы.
Проблемы при запуске DeepSeek, Gemma, Phi на RTX 4090
Сервер пришел с чистой системой без драйвера NVIDIA, установщик Ollama отработал без ошибок и отчитался о готовности, причем скачал набор для карт AMD, поскольку нашел на плате встроенную графику процессора. В журнале службы стояли строки про вычисления на процессоре и нулевой объем видеопамяти:
inference compute id=cpu library=cpu
vram-based default context total_vram="0 B" default_num_ctx=4096
Модели в таком состоянии запускаются и отвечают, только очень медленно. Для диагностики достаточно двух команд - если `nvidia-smi` не находится, а `lspci` показывает карту, значит карта на месте и не хватает драйвера:
lspci | grep -i nvidia
ubuntu-drivers install && reboot
После перезагрузки и перезапуска службы журнал получаем нужный результат:
inference compute id=0 library=CUDA compute=8.9 description="NVIDIA GeForce RTX 4090" total="23.5 GiB"
vram-based default context total_vram="23.5 GiB" default_num_ctx=32768
Окно контекста по умолчанию Ollama выбирает не по возможностям модели, а по объему видеопамяти. На карте в двадцать четыре гигабайта оно равно 32 768 токенам (значение default_num_ctx).
Скорость генерации
Для первого замера каждая модель получала короткий вопрос на русском с окном в восемь тысяч токенов и выдавала ответ длиной 256 токенов. Все девять моделей поместились на карту целиком.
|
Модель |
Объем в Ollama (Гб) |
Генерация (токенов в секунду) |
Потребление памяти (Гб) |
|
gemma4:12b-it-qat |
7.2 |
102.8 |
8.3 |
|
gemma4:26b-a4b-it-qat |
15 |
201.8 |
16 |
|
gemma4:26b. q4_K_M с моделью MTP |
18 |
237.5 |
18.9 |
|
gemma4:31b-it-qat |
18 |
46.5 |
20.1 |
|
gemma4:31b-it-q4_K_M |
19 |
44.2 |
21.1 |
|
deepseek-r1:14b |
9 |
94.4 |
10.1 |
|
phi4-reasoning |
11 |
78.3 |
12.4 |
|
phi4-reasoning:plus |
11 |
78.3 |
12.4 |
|
phi4-mini |
2.5 |
271.6 |
3.9 |
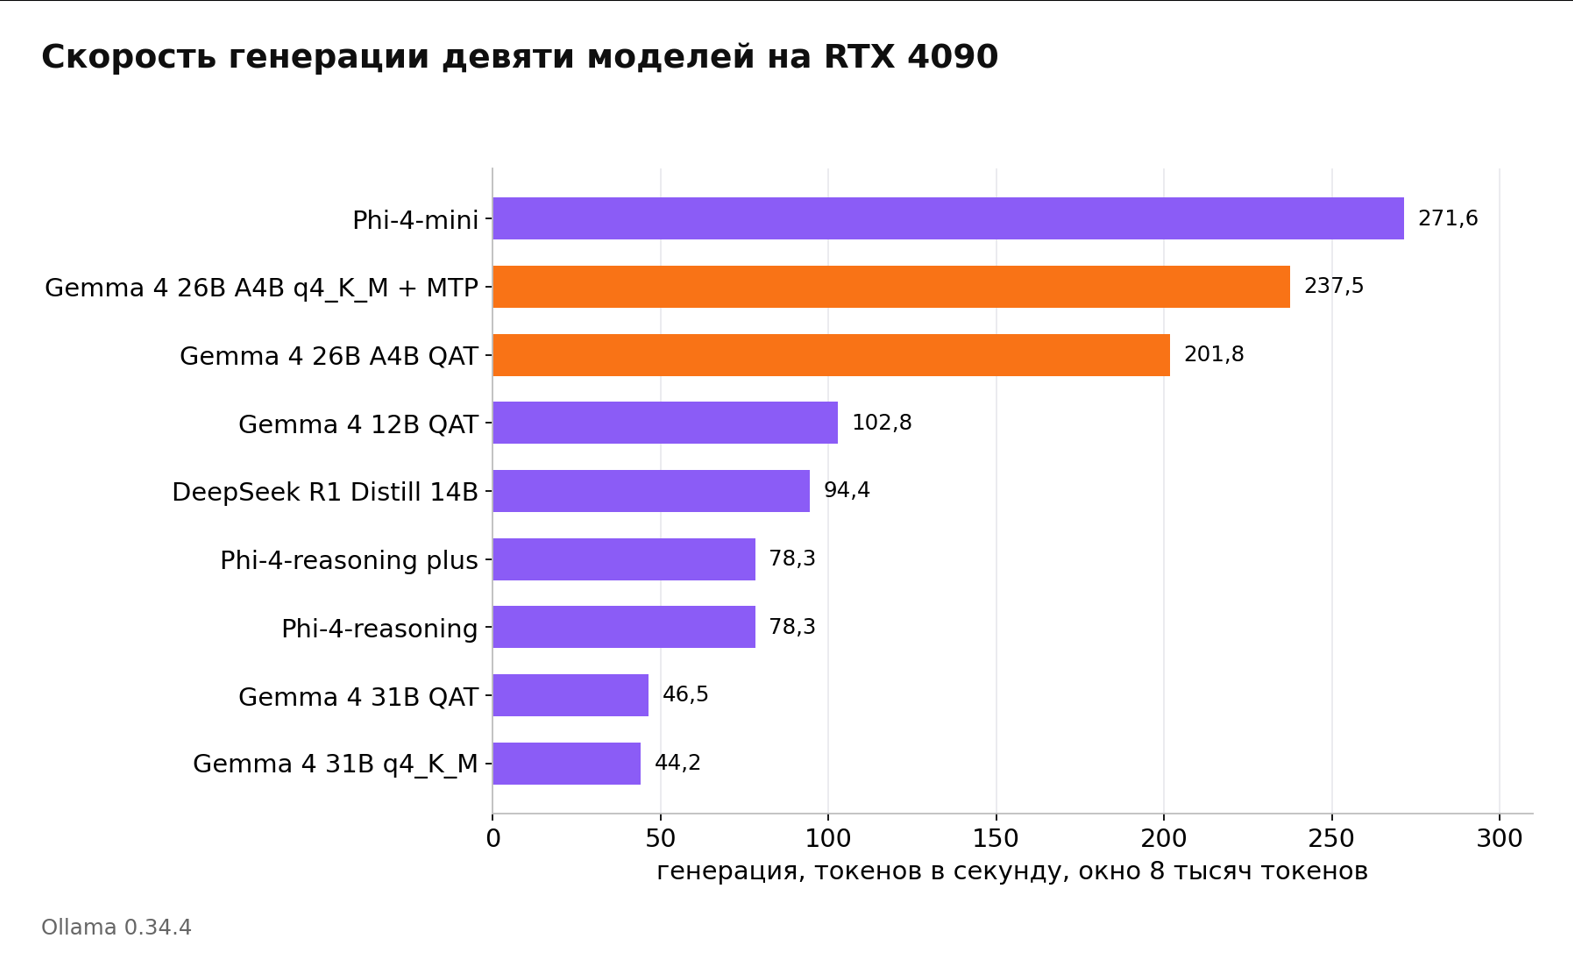
У плотных моделей скорость генерации упирается в основном в пропускную способность видеопамяти. Для Gemma 4 31B (веса около 17.5 Гб), потолок выходит около 57 токенов в секунду, а замер показал 46.5, то есть около восьмидесяти процентов от заявленного теоретического предела. Лучший по скорости результат среди крупных моделей показала Gemma 4 26B A4B со смесью экспертов, 202 токена в секунду, что вдвое быстрее плотной 12B и в 4.3 раза быстрее плотной 31B.
Тег gemma4:26b по умолчанию тянет вариант в сжатии q4_K_M вместе с небольшой дополнительной моделью, которая предлагает черновые токены, а основная модель проверяет их пачкой. В теории подобный подход должен значительно (до трех раз) ускорять работу, но на стенде этот вариант выдал 237.5 токена в секунду против 201.8 у варианта qat без дополнительной модели, то есть только на 18 процентов больше. Сравнение не вполне чистое, поскольку у двух тегов разное сжатие, а вариант q4_K_M без дополнительной модели мы не скачивали.
Окно контекста и переход модели на процессор
Ollama резервирует кэш ключей и значений под все окно контекста сразу при загрузке модели, и чем шире окно, тем больше памяти уходит сверх весов. Чтобы увидеть эту зависимость, мы подавали трем моделям Gemma русский технический текст с окнами от четырех до двухсот пятидесяти шести тысяч токенов. Реальная длина запросов получилась примерно на треть меньше окна, поскольку русский текст токенизировался плотнее, чем мы предполагали.
|
Модель Gemma 4 |
Окно (тысяч токенов) |
Длина запроса (токенов) |
Использовано памяти (Гб) |
Целиком на карте |
Генерация (токенов в секунду) |
|
12B qat |
32 |
19 397 |
8.7 |
да |
93.7 |
|
12B qat |
128 |
77 442 |
11.2 |
да |
82.8 |
|
12B qat |
256 |
154 836 |
12.1 |
да |
76.9 |
|
26B A4B qat |
32 |
19 397 |
16.5 |
да |
153.7 |
|
26B A4B qat |
128 |
77 442 |
18.2 |
да |
130.9 |
|
26B A4B qat |
256 |
154 836 |
20.9 |
да |
112.4 |
|
31B qat |
32 |
19 397 |
22 |
да |
41.2 |
|
31B qat |
48 |
29 070 |
22.7 |
нет |
27.1 |
|
31B qat |
64 |
38 745 |
22.7 |
нет |
8.7 |
|
31B qat |
128 |
77 442 |
22.6 |
нет |
1.9 |
|
31B qat |
256 |
154 836 |
22.6 |
нет |
0.6 |
Модели 12B и 26B A4B прошли весь путь до 256 тысяч, оставаясь целиком на карте. У 12B занятая память выросла от окна в четыре тысячи до 256 тысяч всего на четыре гигабайта, у 26B A4B на пять. Можно предположить, что такой результат это заслуга архитектуры.
У Gemma 4 31B результат иной. До окна в 32 тысячи модель работает на карте с генерацией около 41 токена в секунду, а уже на окне в 48 тысяч часть слоев уходит на процессор. Несмотря на это, Ollama не выдает никакого предупреждения, запрос завершается штатно, и единственный признак проблемы это падение скорости до 27 токенов в секунду, на окне в 64 тысячи до 8.7, а на 256 тысячах до 0.6, то есть почти в семьдесят раз. Понять причину замедления можно только с помощью ollama ps, в колонке PROCESSOR вместо 100% GPU появляется доля процессора.
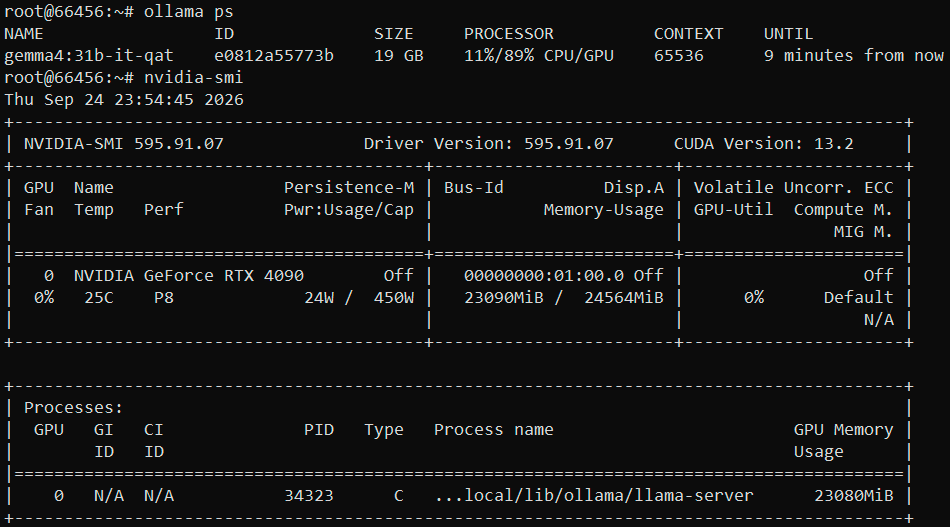
Процесс, который держит модель в видеопамяти, называется `llama-server`, то есть Ollama внутри запускает сервер из llama.cpp и наследует все его особенности, включая резервирование кэша под все окно.
Окно контекста передается в каждом запросе, и если оно отличается от того, с которым модель загружена, Ollama перезагружает модель целиком, из-за чего запрос ждет лишние три-пять секунд. На стенде такую особенность поведения удалось поймать случайно, прогрев шел с одним окном, а замер с другим. В тестовой среде подобное можно и игнорировать, а вот в продуктовой среде может быть просадка качества. Поэтому окно лучше зафиксировать переменной OLLAMA_CONTEXT_LENGTH в настройках службы. Например, со значением 16384:
Environment="OLLAMA_CONTEXT_LENGTH=16384"Сжатие кэша до восьми бит
Ollama умеет хранить кэш ключей и значений в восьмибитном виде. Для этого необходимо выполнить:
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"|
Окно (тысяч токенов) |
Использовано памяти (Гб) |
Целиком на карте |
Генерация, кэш в 8 битах |
Генерация, кэш по умолчанию |
|
32 |
20.5 |
да |
37.2 |
41.2 |
|
48 |
21.3 |
да |
34.4 |
27.1 |
|
64 |
22.1 |
да |
31.9 |
8.7 |
|
128 |
22.7 |
нет |
6.5 |
1.9 |
Со сжатым кэшем модель целиком помещается на карту до окна в 64 тысячи токенов и генерирует на нем 31.9 токена в секунду вместо 8.7, то есть работает в 3.7 раза быстрее. Минус такого метода в снижении скорости генерации на окне в 32 тысячи с 41.2 до 37.2.
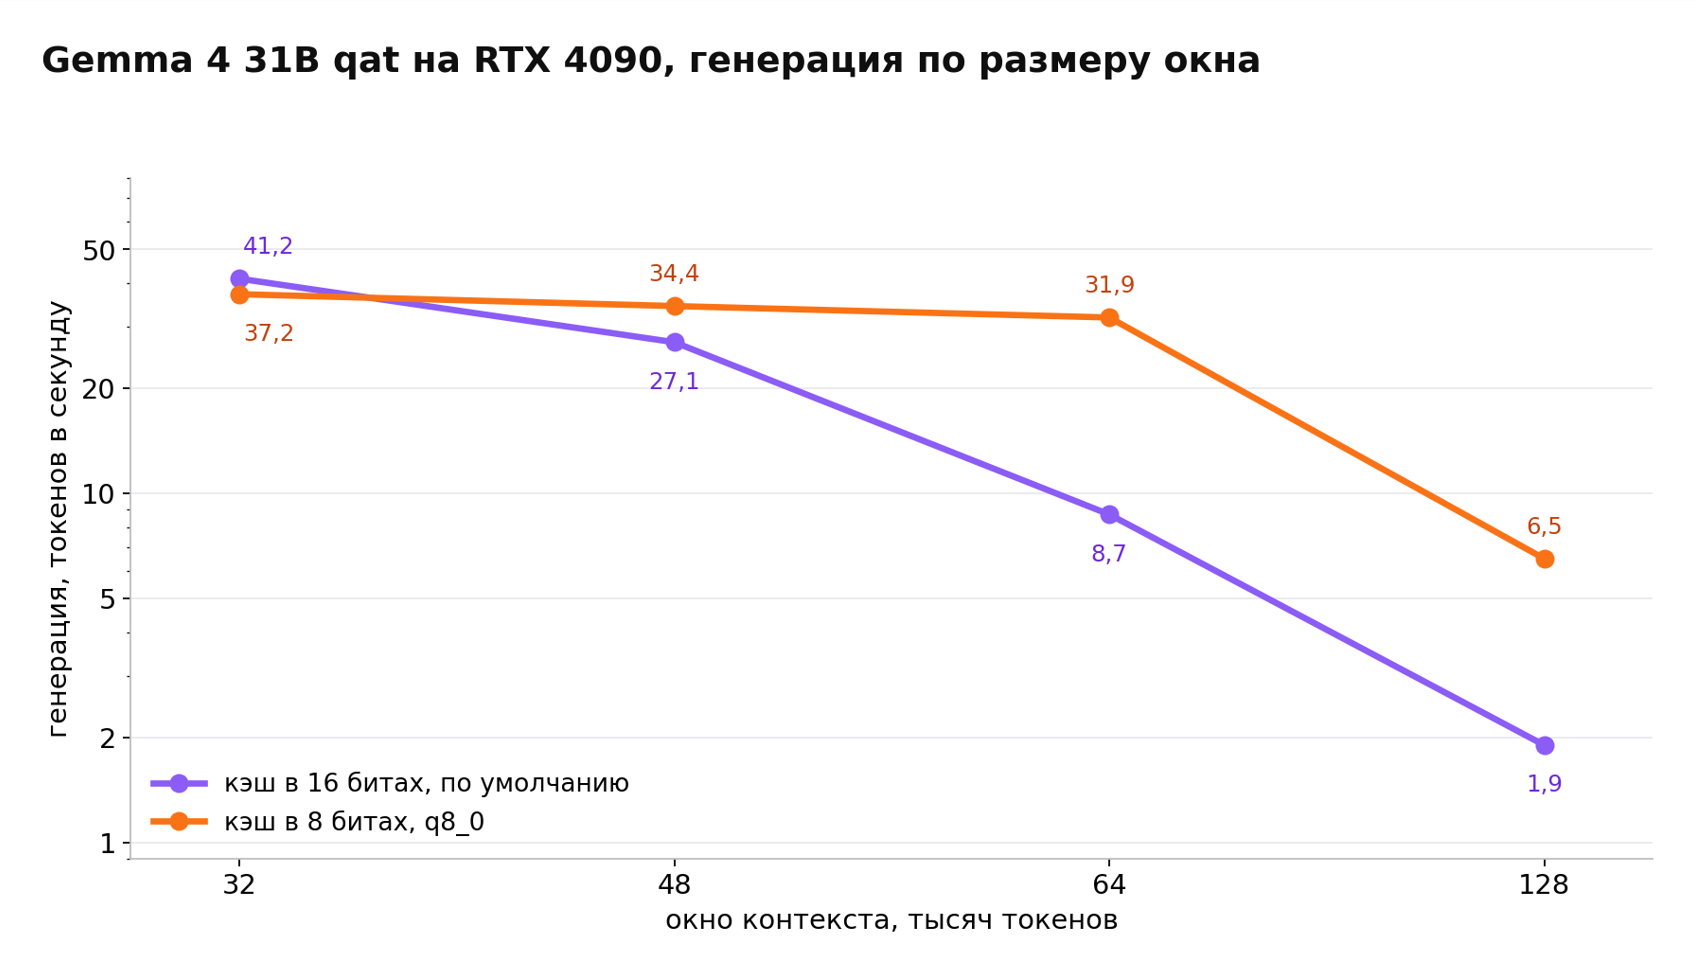
Gemma 4 31B на RTX 4090, скорость генерации по размеру окна при обычном и сжатом кэше
Проектор изображений
Ollama держит проектор изображений в видеопамяти в том числе при работе только с текстом. Для проверки мы собрали из того же файла весов модель без проектора и загрузили обе с одинаковыми окнами.
|
Gemma 4 31B qat |
Окно (тысяч токенов) |
Использовано памяти (Гб) |
Целиком на карте |
Генерация (токенов в секунду) |
|
с проектором |
32 |
22 |
да |
41.2 |
|
с проектором |
48 |
22.7 |
нет |
27.1 |
|
без проектора |
32 |
20.8 |
да |
- |
|
без проектора |
48 |
22 |
да |
40.1 |
|
без проектора |
64 |
22.5 |
нет |
22.7 |
Текстовую версию модели можно собрать из уже скачанных файлов. В описании исходной модели две строки FROM, первая ссылается на файл весов, вторая на проектор. Достаточно удалить вторую, сохранив шаблон диалога и параметры. Собранная таким образом модель ответила на вопрос по-русски так же, как исходная:
ollama show gemma4:31b-it-qat --modelfile > Modelfile
#Удалить вторую строку FROM, которая ссылается на проектор
ollama create gemma4-31b-text -f Modelfile
Модель без экономии кэша
Для сравнения тот же замер провели для дистиллята DeepSeek R1 на четырнадцать миллиардов параметров, построенный на Qwen2.5 и близкий по размеру к Gemma 12B.
|
Окно контекста (тысяч токенов) |
Длина запроса (токенов) |
Использовано памяти (Гб) |
Целиком на карте |
Генерация (токенов в секунду) |
|
32 |
24 690 |
14.7 |
да |
63.3 |
|
64 |
49 334 |
20.6 |
да |
48.0 |
|
128 |
98 622 |
22.2 |
нет |
1.1 |
Кэш дистиллята растет на 0.18 Гб на каждую тысячу токенов окна, у Gemma 12B примерно на 0.026, то есть почти в семь раз медленнее, а на окне в 128 тысяч дистиллят уже не помещается на карту и генерирует 1.1 токена в секунду.
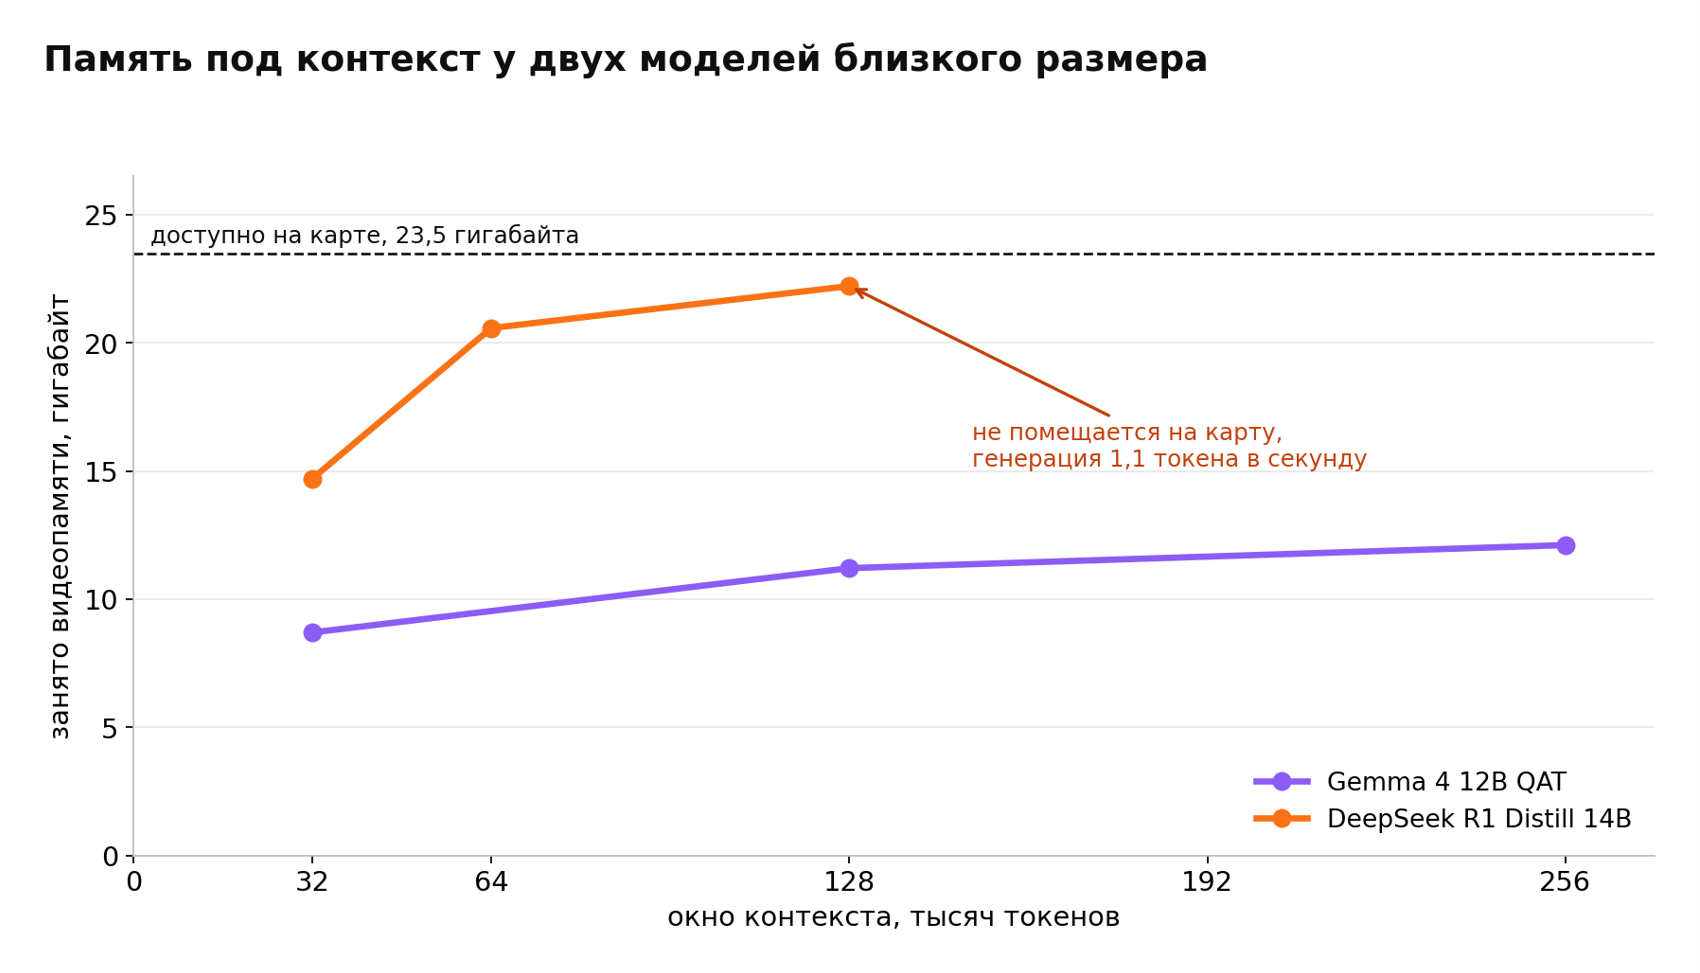
Память под контекст у двух моделей близкого размера на одной RTX 4090
Качество ответов при сжатом кэше
Для проверки качества ответов при сжатом кэше наш сценарий собирает журнал на русском языке длиной около 57 тысяч токенов. Затем прячет в нем восемь фактов (например, "инженер Смирнов хранит ключ доступа к архиву, код ключа ЕВ-7468"), после чего восемь раз спрашивает модель о фактах об инженерах. Для теста использовали модель Gemma 4 26B A4B.
|
Документ |
Кэш по умолчанию |
Кэш q8_0 |
|
первый |
8 из 8 |
7 из 8 |
|
второй |
5 из 8 |
6 из 8 |
|
третий |
8 из 8 |
8 из 8 |
|
итого |
21 из 24 |
21 из 24 |
Результат совпал, а большинство ошибок оказались общими для обоих режимов, так что вызваны они скорее трудностью документа для самой модели, а не сжатием. Сам по себе поиск фактов в длинном документе у модели не безупречен. Примерно в одном случае из восьми она путала, кому принадлежит код, называла настоящий код из того же документа, принадлежащий другому инженеру, в других случаях искажала буквы в коде или вместо ответа начинала пересказывать вопрос.
Как модели справляются с русским языком
На длинном русском журнале токенизатор Qwen в дистилляте DeepSeek насчитал 24 690 токенов, а токенизатор Gemma 19 397, т. е. получилась разница в 27 %. Нам все же было любопытно узнать, насколько русский тяжелее для моделей, поэтому мы отдали трем токенизаторам один и тот же абзац про отказоустойчивость кластера на русском языке и в английском переводе, повторенный двадцать раз.
|
Модель |
Количество токенов на русском |
Количество токенов на английском |
Русский дороже (%) |
Генерация на русском (токенов в секунду) |
Генерация на английском (токенов в секунду) |
|
Gemma 4 |
3 122 |
2 382 |
31 |
102.6 |
103.1 |
|
DeepSeek R1 Distill 14B |
4 082 |
2 462 |
66 |
94.5 |
94.3 |
|
Phi-4-mini |
3 141 |
2 501 |
26 |
275.6 |
276.2 |
Английский текст все три токенизатора режут почти одинаково, от 2 382 до 2 501 токена, а русский по-разному - и хуже всех справляется токенизатор Qwen в дистилляте DeepSeek. Скорость генерации в токенах от языка практически не зависит, разница меньше полупроцента. Отсюда простая арифметика для выбора модели. При одинаковой скорости в токенах дистиллят DeepSeek выдает русского текста на сорок процентов меньше, чем английского, поскольку каждое русское слово стоит в 1.66 раза больше токенов, и во столько же раз меньше русского текста помещается в то же окно. У Gemma с ее словарем на 262 тысячи записей эта надбавка вдвое меньше.
Рассуждают модели при этом по-английски. На русскую задачу про делимость многочлена все три рассуждающие модели думали на английском, а ответ дали на русском. Phi-4-reasoning начала с того, что перевела условие, а версия plus потратила заметную часть рассуждения на выяснение, что именно означает слово "делится" и как быть с делением на ноль при x, равном единице. Gemma 4 рассуждает по-английски даже в ответ на простое "привет", и на вопрос о столице Франции через программный интерфейс вернула рассуждение на английском, а ответ "Париж" по-русски.
Microsoft в карточке Phi-4 предупреждает, что модель ориентирована на английский и не предназначена для многоязычного применения, тем не менее на этой задаче обе версии Phi ответили верно и изложили решение грамотным русским. На английском варианте теста с поиском фактов, где документ того же объема в символах занял 47 тысяч токенов против 57 тысяч у русского, Gemma 4 26B A4B нашла 23 факта из 24 против 21 на русском. Разница укладывается в разброс между отдельными документами, так что говорить о влиянии языка по этому тесту нельзя, а характер единственной ошибки тот же, модель перепутала, кому принадлежит код. Одна школьная задача и двадцать четыре вопроса ничего не говорят о работе с русскими текстами в целом, поэтому перед использованием в продуктовой среде модель стоит проверить на собственных данных.
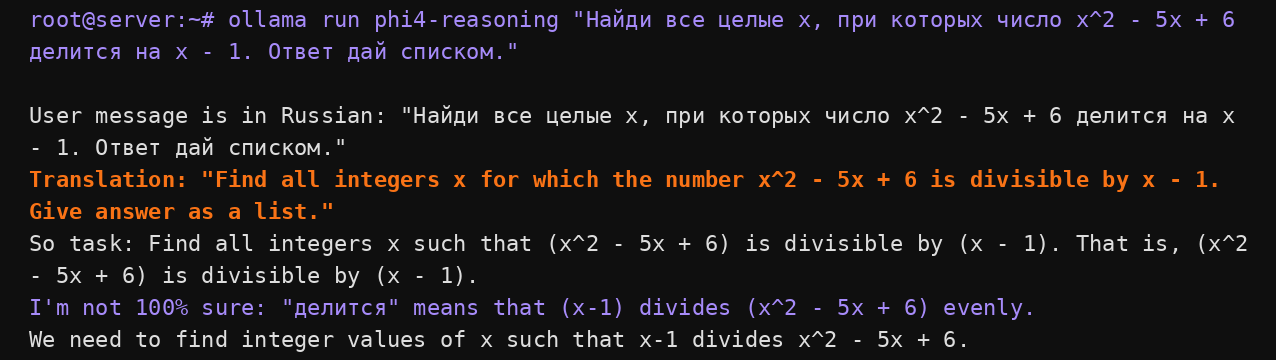
Phi-4-reasoning сначала переводит условие задачи на английский
Стоимость рассуждения
Ту же задачу мы использовали, чтобы посмотреть, во что обходится режим рассуждения.
|
Модель, режим |
Токенов в ответе |
Время работы (секунды) |
Генерация (токенов в секунду) |
Качество ответа |
|
phi4-reasoning |
1 863 |
24.1 |
77.4 |
верный |
|
phi4-reasoning:plus |
2 893 |
37.9 |
76.4 |
верный |
|
gemma4:26b-a4b-it-qat. с рассуждением |
1 556 |
8.1 |
195.9 |
верный |
|
gemma4:26b-a4b-it-qat. без рассуждения |
606 |
3.2 |
197.7 |
верный |
Версия plus задействовала на 55 процентов больше токенов, чем обычная рассуждающая Phi, и отвечала в полтора раза дольше. На этой задаче лишние токены ничего не дали, обе версии ответили верно. В статистике Ollama при этом видно 485 токенов запроса на вопрос примерно в тридцать токенов, поскольку Ollama сама подставляет длинное системное сообщение Microsoft из шаблона модели. А вот длина рассуждения заметно гуляет. На той же задаче, заданной по-английски, Phi-4-reasoning написала 1 944 токена, почти столько же, сколько на русском, а Gemma рассуждала 2 818 токенов против 1 556, и обе снова ответили верно. По одной паре запусков сравнивать языки нельзя, зато видно, что время ответа рассуждающей модели легко меняется в полтора-два раза от запроса к запросу. Gemma 4 в Ollama рассуждает по умолчанию и на простое "привет" модель 12B потратила 211 токенов, из которых на сам ответ пришлось около десяти.
Несколько одновременных пользователей Ollama
Для одновременной работы нескольких клиентов у Ollama есть переменная OLLAMA_NUM_PARALLEL. С шестнадцатью слотами модель 12B при единственном запросе заняла 23 гигабайта вместо восьми и частично ушла на процессор.
|
Настройка |
gemma4:12b-it-qat занимает по ollama ps (Гб) |
Где находится |
Окно контекста (токенов) |
|
OLLAMA_NUM_PARALLEL=16 |
23 |
7 % на процессоре |
4096 |
|
OLLAMA_NUM_PARALLEL=1 |
8 |
целиком на карте |
32 768 |
Ollama резервирует кэш под каждый слот заранее, так что настройка, которая выглядит как разрешение обслуживать больше пользователей, умножает расход памяти на кэш на число слотов, даже когда запрос один. С десятью слотами и окном в восемь тысяч токенов обе модели среднего размера поместились на карту. Им отправляли одинаковые запросы с ответом длиной 512 токенов.
|
Количество клиентов |
12B суммарно |
12B на клиента |
26B A4B суммарно |
26B A4B на клиента |
|
1 |
102.9 |
103.9 |
194.5 |
201.3 |
|
3 |
268.1 |
91.7 |
437.9 |
151 |
|
10 |
567.9 |
59.3 |
691.6 |
71.8 |
Плотная модель на десяти клиентах наращивает суммарную пропускную способность в 5.5 раза, модель со смесью экспертов только в 3.6, т.к. токены разных запросов выбирают разных экспертов и из памяти приходится читать заметно большую часть модели. Преимущество MoE сжимается с двукратного при одном пользователе до 22 процентов при десяти, хотя по суммарной скорости она все равно остается впереди, 692 токена в секунду против 568. Под нагрузкой MoE-модель к тому же берет меньше мощности, до 285 ватт против 341 у плотной.
Ollama против vLLM
Ollama удобна для одного пользователя, а для сервиса на большое количество одновременных клиентов обычно берут vLLM. Преимущество последнего подхода в том, что он на каждом шаге генерации собирает токены всех активных запросов в общий пакет. Для сравнения движков мы запустили в vLLM ту же Gemma 4 12B, причем тоже в официальном четырехбитном варианте Google, только в формате w4a16 для серверных движков вместо Q4_0. Этот вариант весит 10.3 гигабайта против 7.2 в Ollama, поскольку часть весов в нем оставлена в исходной точности. Перед запуском vLLM мы остановили службу Ollama.
Docker и доступ к видеокарте
vLLM проще всего запускать из готового образа. Для этого необходимо установить Docker и набор NVIDIA Container Toolkit, через который контейнеры получают доступ к видеокарте. Docker из репозитория Ubuntu ставится одной командой, а набор NVIDIA из репозитория компании:
apt-get install -y docker.io
curl -fsSL https://nvidia.github.io/libnvidia-container/gpgkey | gpg --dearmor -o /usr/share/keyrings/nvidia-container-toolkit-keyring.gpg
curl -s -L https://nvidia.github.io/libnvidia-container/stable/deb/nvidia-container-toolkit.list | sed 's#deb https://#deb [signed-by=/usr/share/keyrings/nvidia-container-toolkit-keyring.gpg] https://#g' > /etc/apt/sources.list.d/nvidia-container-toolkit.list
apt-get update && apt-get install -y nvidia-container-toolkit
nvidia-ctk runtime configure --runtime=docker && systemctl restart docker
При установке может возникнуть проблема. Общее обновление списков пакетов повисло на одном из зеркал Ubuntu, хотя репозиторий NVIDIA к тому моменту уже был скачан, и помогло обновление только этого репозитория:
apt-get update -o Dir::Etc::sourcelist="sources.list.d/nvidia-container-toolkit.list" -o Dir::Etc::sourceparts="-" -o APT::Get::List-Cleanup="0"Контейнер видит карту, если следующая команда выводит ту же таблицу, что и nvidia-smi:
docker run --rm --gpus all ubuntu nvidia-smiПорт Docker
Первый запуск vLLM с привычным ключом -p 8000:8000 открыл сервер на всех адресах машины, в журнале так и написано Starting vLLM server on http://0.0.0.0:8000. Проверки доступа у vLLM по умолчанию нет, а Docker прописывает свои правила в сетевой фильтр ядра в обход ufw, так что даже включенный межсетевой экран такой порт не закроет, и любой, кто знает адрес сервера, получает бесплатный доступ к видеокарте. Лечится это привязкой порта к локальному адресу, а если сервер все же нужен снаружи, vLLM умеет требовать ключ доступа параметром --api-key:
docker run -d --name vllm --gpus all -p 127.0.0.1:8000:8000 --ipc=host \
  -v /root/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:latest \
  --model google/gemma-4-12B-it-qat-w4a16-ct \
  --max-model-len 8192 --gpu-memory-utilization 0.90 --kv-cache-dtype fp8
Результаты
Каждый клиент получал тот же вопрос, что и в замерах Ollama, и 512 токенов ответа. Тридцать и больше клиентов мы пробовали только в vLLM, поскольку в Ollama при десяти слотах лишние запросы просто встают в очередь.
|
Количество клиентов |
Ollama суммарно |
vLLM суммарно |
vLLM на клиента |
vLLM с кэшем FP8 суммарно |
|
1 |
102.9 |
95.1 |
95.1 |
96.7 |
|
3 |
268.1 |
276.6 |
92.3 |
- |
|
10 |
567.9 |
815.6 |
81.6 |
868.3 |
|
30 |
- |
1 970.2 |
65.8 |
- |
|
60 |
- |
2 680.1 |
44.8 |
3 164.8 |
|
100 |
- |
2 306.8 |
28 |
3 278.5 |
|
150 |
- |
- |
- |
3 254.2 |
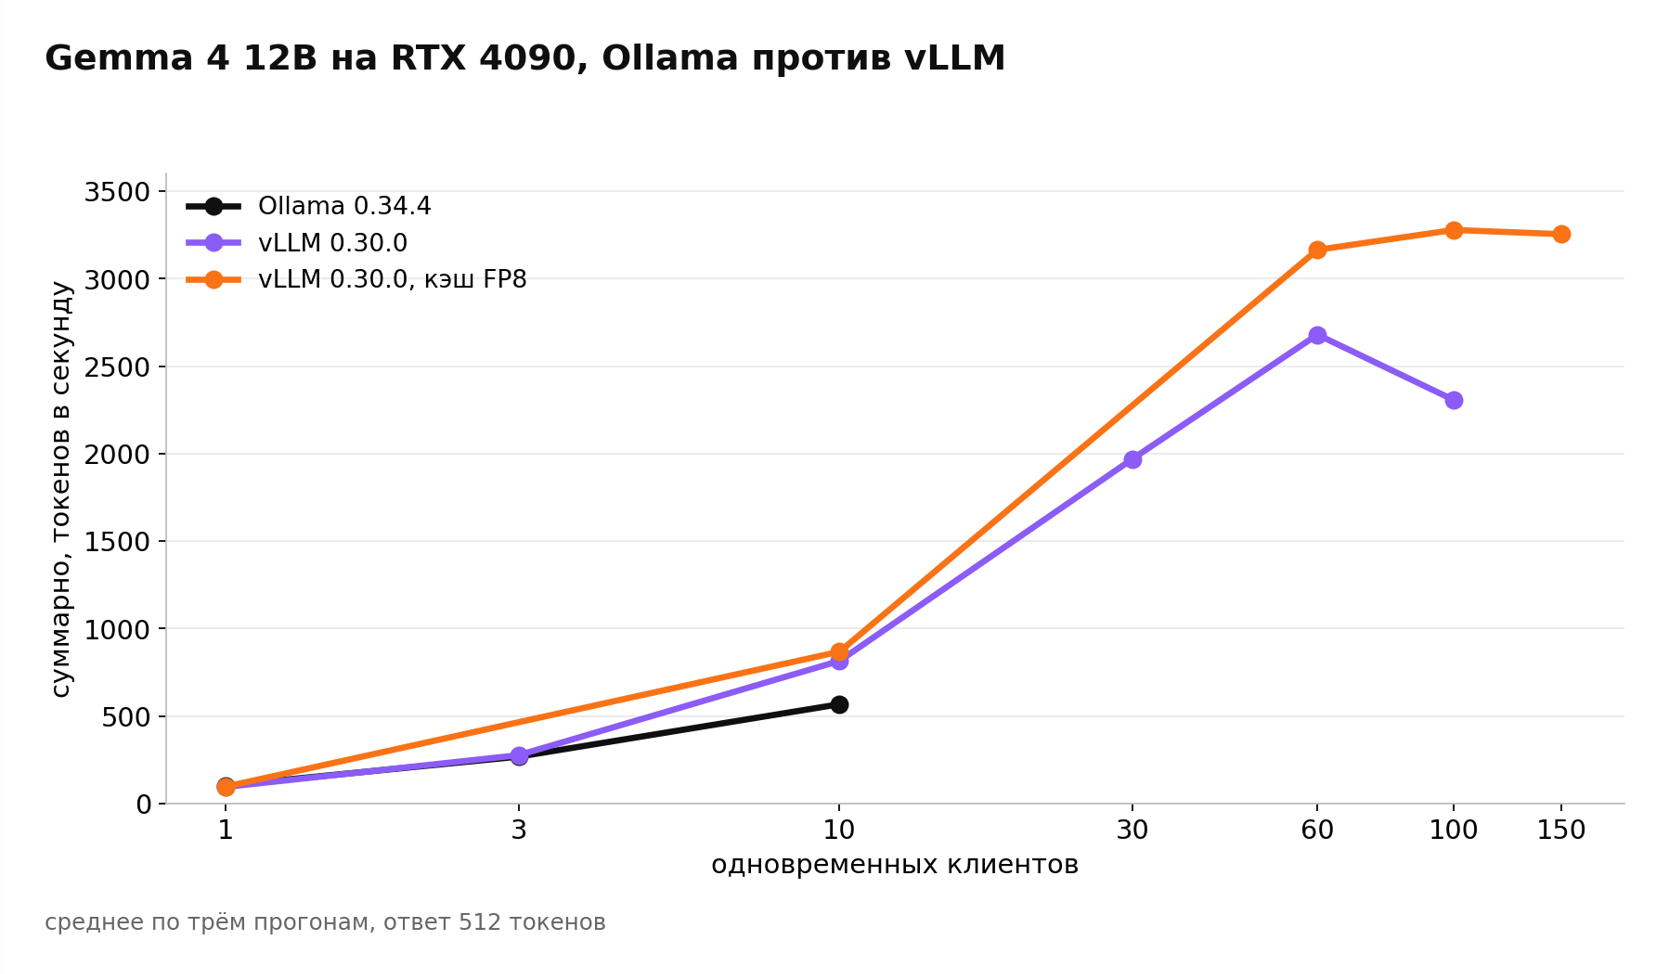
Gemma 4 12B, Ollama против vLLM по числу клиентов
На одном пользователе Ollama быстрее примерно на восемь процентов, на трех движки почти сравнялись. На десяти vLLM выдает на 44 процента больше суммарно, и каждый пользователь получает ответ на 38 процентов быстрее, На тридцати клиентах скорость на каждого в vLLM, 65.8 - все еще выше, чем у Ollama на десяти.
Границы памяти у vLLM
vLLM при запуске сразу забрал 22.1 гигабайта из 24, хотя модель весит около десяти. Это не результат ошибок, а устройство движка - он резервирует девяносто процентов видеопамяти под кэш заранее, поэтому сравнивать занятую память у Ollama и vLLM бессмысленно.
Объем этого резерва vLLM пишет в журнал при запуске, особого внимания заслуживает эта строка:
GPU KV cache size: 47,385 tokens, Maximum concurrency for 8,192 tokens per request: 5.78xЧисло 5.78 означает, что одновременно поместятся всего шесть запросов, если каждый займет все окно в восемь тысяч токенов. Наш запрос вместе с ответом занимал около 550 токенов, так что помещалось примерно 86 одновременных запросов, и на ста клиентах суммарная скорость не выросла, а упала на четырнадцать процентов, поскольку части запросов пришлось ждать или пересчитываться заново.
Сжатие кэша в vLLM
С параметром --kv-cache-dtype fp8 vLLM хранит кэш в восьмибитном формате. 4090 поддерживает этот формат аппаратно, и объем кэша в журнале вырос вдвое, до 94 942 токенов. В отличие от Ollama, где сжатие стоило около десяти процентов скорости, в vLLM оно скорость только прибавило, на одном клиенте на два процента, на десяти на шесть, на шестидесяти на восемнадцать, а на ста на сорок два. При генерации карта на каждом шаге читает не только веса, но и кэш всех активных запросов. Соответственно, если запросов сотня, сжатый вдвое кэш читается заметно быстрее.
Для одного пользователя Ollama чуть быстрее и несравнимо проще в настройке. Для сервиса на десятки пользователей vLLM со сжатым кэшем на той же карте выдает в полтора раза больше уже на десяти клиентах и держит под сотню одновременных диалогов.
Программный интерфейс и безопасность Ollama
По умолчанию служба Ollama слушает только локальный адрес 127.0.0.1:11434, что на стенде мы проверили командой ss -tlnp, так что снаружи к ней не подключиться. Наружу доступ можно открыть, указав параметр OLLAMA_HOST=0.0.0.0, только ставить такой инстанс без прокси с аутентификацией не стоит, поскольку собственной проверки доступа у Ollama нет.
Кроме собственного интерфейса Ollama отдает интерфейс, совместимый с OpenAI, и любая библиотека для OpenAI подключается к нему заменой адреса:
curl -s http://127.0.0.1:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"gemma4:12b-it-qat","reasoning_effort":"none","messages":[{"role":"user","content":"Назови столицу Франции одним словом"}]}'
Рассуждение модели этот интерфейс отдает в отдельном поле reasoning, так что клиентский код видит чистый ответ в поле content, однако токены рассуждения всё равно генерируются и занимают время. Ниже тот же запрос без параметра reasoning_effort.
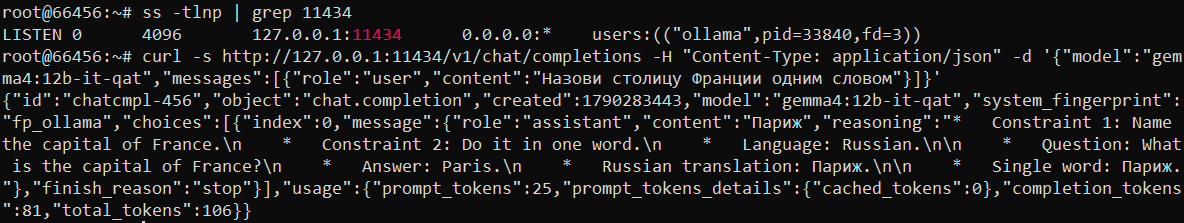
Ответ из одного слова стоил 81 токен рассуждения
С рассуждением ответ "Париж" занял 81 токен, а с параметром "reasoning_effort": "none", как в примере выше, всего 4, поскольку модель сразу выдаёт ответ без размышлений.
Можно ли работать без видеокарты
Ollama считает на процессоре автоматически, если видеокарты нет, а на сервере с картой то же самое можно получить для отдельного запроса параметром num_gpu, равным нулю. Этим мы и воспользовались.
|
Модель |
Генерация на процессоре (токенов в секунду) |
Генерация на 4090 (токенов в секунду) |
Во сколько раз медленнее |
|
phi4-mini |
17.5 |
271.6 |
15.5 |
|
gemma4:12b-it-qat |
6.1 |
102.8 |
16.9 |
|
gemma4:26b-a4b-it-qat |
16.8 |
201.8 |
12 |
|
gemma4:31b-it-qat |
2.5 |
46.5 |
18.6 |
На процессоре MoE-модель на двадцать шесть миллиардов параметров генерирует почти так же быстро, как Phi-4-mini на 3.8 миллиарда, и в 2.75 раза быстрее плотной 12B, так что для сервера без видеокарты с достаточным объемом оперативной памяти выбор модели очевиден.
Генерация на процессоре упирается в скорость чтения оперативной памяти так же, как на видеокарте упирается в видеопамять. Веса 31B занимают около 17.6 Гб, и при 2.5 токенах в секунду процессор обрабатывает около 44 Гб в секунду. У 12B выходит 7 гигабайт на 6.1 токена, те же 43 гигабайта в секунду, а у MoE-модели, которая читает на токен около 2.6 гигабайта задействованных весов, при 16.8 токена снова около 44. Скорость генерации, таким образом, примерно равна пропускной способности памяти, деленной на объем весов, читаемых на один токен.
Обработка запроса на процессоре тоже медленная, и для длинных документов это важнее генерации. У 12B при 80 токенах в секунду документ на двадцать тысяч токенов будет обрабатываться больше четырех минут, прежде чем модель напишет первое слово, тогда как на 4090 это занимает около трех секунд. Запросы в этом замере были короткими, так что скорость обработки тут ориентировочная.
Холодный старт
|
Условия |
Загрузка gemma4:31b-it-qat (секунд) |
|
Файл читается с NVMe после сброса кэша системы |
10.4 |
|
Файл уже в памяти системы |
4.4 |
Даже с локального NVMe первый запрос после перезапуска службы занимает десять секунд, прежде чем модель начнет отвечать. Ollama по умолчанию выгружает модель после пяти минут простоя, и следующий пользователь получает эту задержку. В качестве решения можно использовать значение OLLAMA_KEEP_ALIVE=-1, это позволяет держать модель в памяти постоянно.
Какая модель подходит для чата, документов и многопользовательского сервиса
|
Задача |
Модель |
Движок и настройки |
Результат на одной RTX 4090 |
|
Чат или помощник для одного пользователя |
Gemma 4 26B A4B qat |
Ollama |
около 200 токенов в секунду |
|
Длинные документы, поиск по базе знаний |
Gemma 4 26B A4B qat |
Ollama, окно задается явно |
все окно в 256 тысяч токенов на карте, генерация от 110 токенов в секунду |
|
Максимальное качество на одной карте |
Gemma 4 31B qat |
Ollama, кэш q8_0 или текстовая версия без проектора |
окно до 64 тысяч токенов, от 32 до 46 токенов в секунду |
|
Сервис для многих пользователей |
Gemma 4 12B qat w4a16 |
vLLM, кэш FP8 |
в сумме до 3 300 токенов в секунду, около сотни коротких диалогов одновременно |
|
Задачи с рассуждением |
Gemma 4 26B A4B с рассуждением или Phi-4-reasoning |
Ollama |
Gemma отвечает втрое быстрее Phi на той же задаче |
|
Простые задачи на минимальном железе |
Phi-4-mini |
Ollama |
272 токена в секунду на карте, 17.5 на процессоре |
Что по итогу?
В 2026 году запуск языковой модели на собственном сервере с одной RTX 4090 — это не экзотика, а рабочий сценарий. Ожидаемое, что из трёх рассмотренных семейств на одной карте с 24 Гб видеопамяти лучше всего себя показала Gemma 4: архитектура с локальным вниманием и экономным кэшем позволяет старшим моделям держать окно до 256 тысяч токенов целиком на GPU, а MoE-вариант 26B A4B выдаёт около 200 токенов в секунду — вдвое быстрее плотной 12B и вчетверо быстрее 31B. Да и она наиболее современная.
По движкам: для одного пользователя Ollama проще и на 8% быстрее; для десятков одновременных клиентов vLLM со сжатым кэшем FP8 выдаёт в 1,5 раза больше already на десяти клиентах и держит до сотни параллельных диалогов. Единственный нюанс — vLLM сразу резервирует 90% видеопамяти под кэш, так что сравнивать занятую память двух движков напрямую нельзя.
Для русскоязычных задач Gemma 4 выглядит как оптимальный выбор: большой словарь на 262 тысячи записей, умеренная токенизация русского, компактный кэш и высокая скорость.
Важное ограничение: в обзоре не участвовали последние модели семейства Qwen — в частности, Qwen 3.8B и другие свежие релизы. По качеству ответов они при сопоставимых размерах превосходят Gemma 4 и DeepSeek, однако работают медленнее. Если качество ответов важнее скорости и у вас есть запас по вычислительным ресурсам, имеет смысл провести отдельное сравнение с актуальной линейкой Qwen перед окончательным выбором модели для боевого применения.
Последние версии популярных LLM-моделей уже предустановлены на вашем сервере.